프로파일링 가이드
저수준(Low-level) 프로파일링은 첫 토큰까지의 시간(TTFT)과 출력 토큰당 시간(TPOT) 같은 요청 단위 메트릭 외에 NPU 실행을 측정합니다.
이 문서는 PyTorch 프로파일러와 RBLN 프로파일러를 사용하는 프로파일링 방법을 설명합니다.
1. PyTorch Profiler
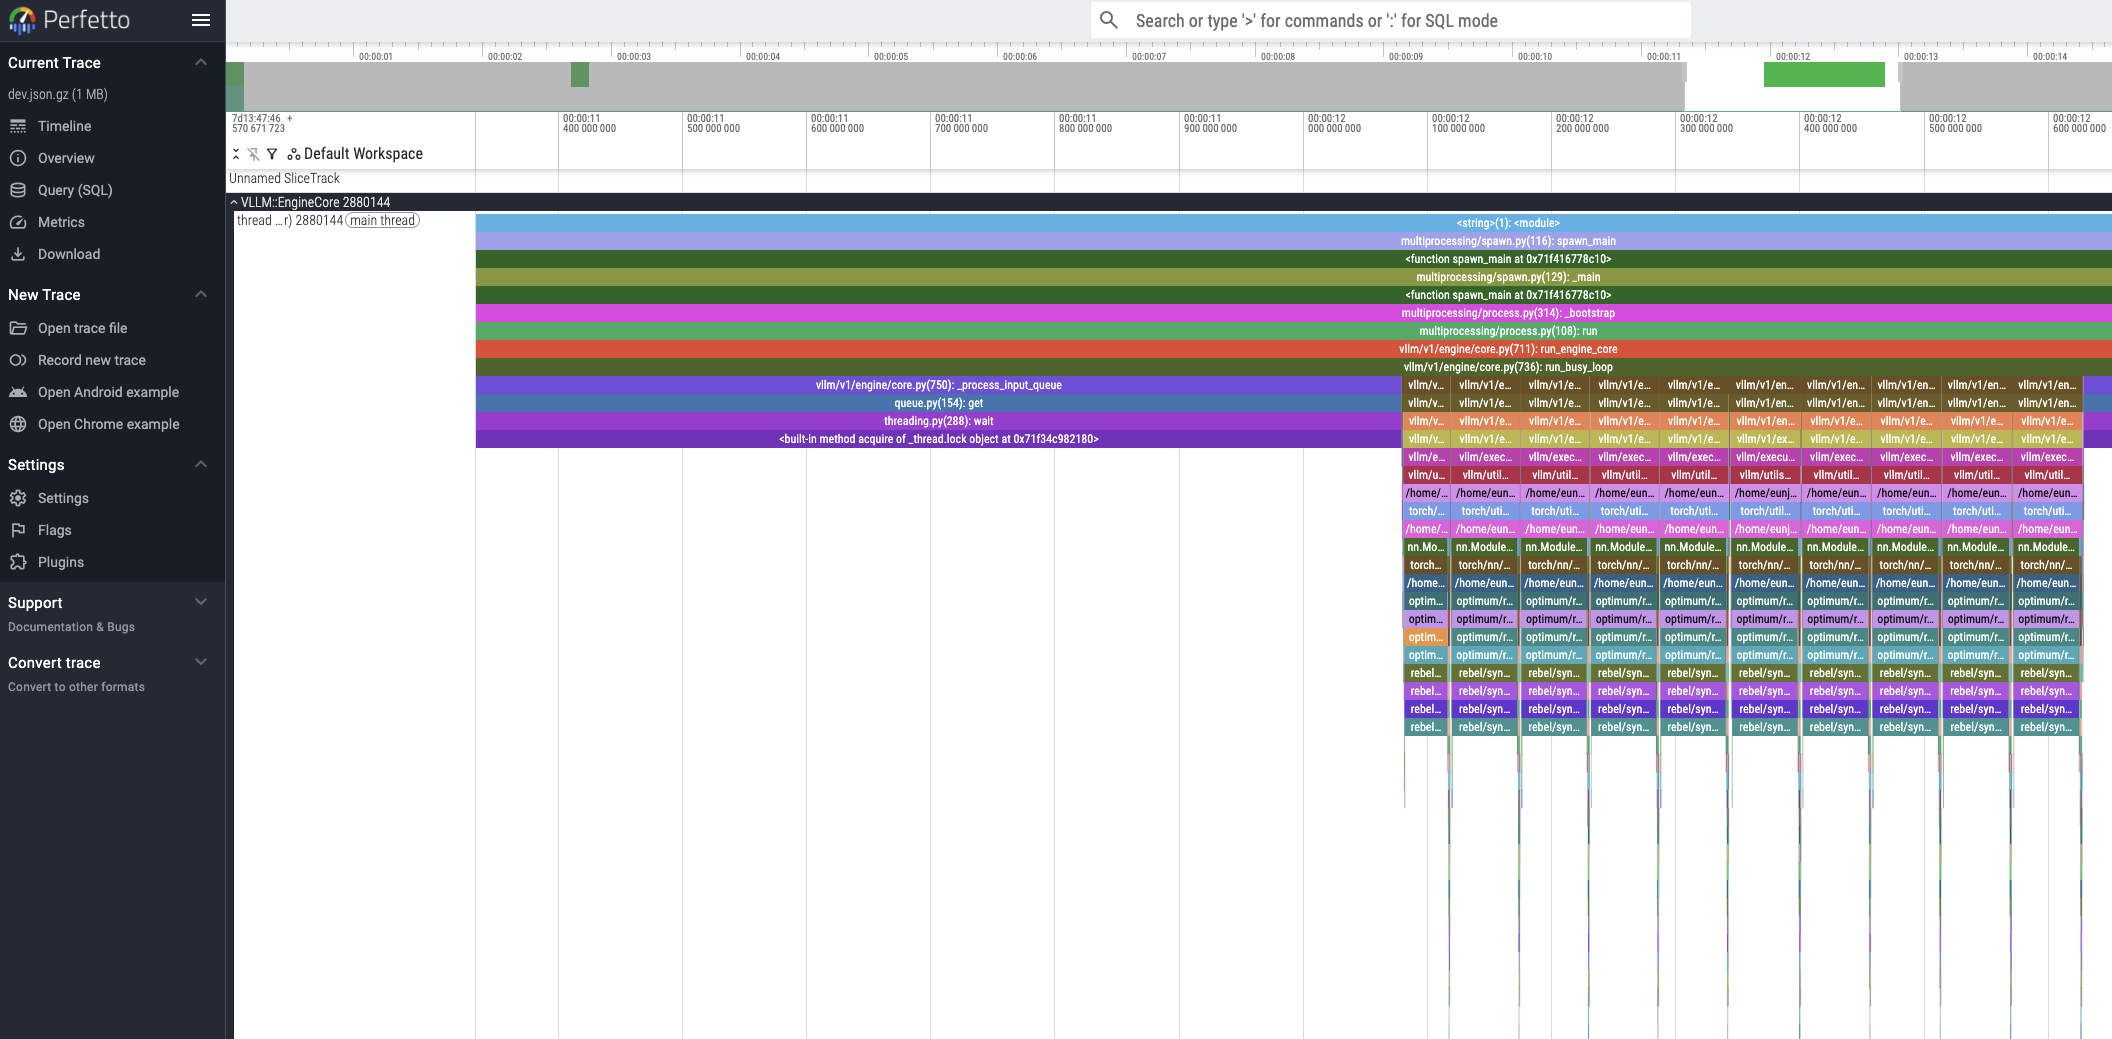
PyTorch 프로파일러를 활용하여 연산 단위의 성능을 측정하는 방법입니다. 이를 통해 커널(Kernel) 실행 시간과 연산 병목 구간을 분석할 수 있습니다. RBLN vLLM은 공식 vLLM Profiling 가이드와 동일한 인터페이스를 지원합니다.
Note
이전에는 환경 변수로 프로파일링 설정이 이루어졌으나 프로파일링을 위한 환경 변수가 deprecated되기 시작했습니다. RBLN vLLM v0.10.1부터는 LLM의 profiler_config 파라미터로 프로파일링을 설정합니다.
1.1 Offline Inference 프로파일링
Python 스크립트를 통한 오프라인 추론 시, 프로파일링 파라미터를 LLM에 전달하고 측정할 코드 앞에서 start_profile()을, 뒤에서 stop_profile()을 호출합니다.
1.2 Online Inference 프로파일링
API 서버를 이용한 online inference를 위해서 먼저 --profiler-config 옵션을 사용하여 OpenAI 호환 서버를 실행합니다.
그 후에 별도의 엔드포인트를 호출하여 프로파일링을 제어합니다.
/start_profile엔드포인트를 호출하여 프로파일링을 시작합니다./v1/chat/completions등 실제 추론 요청을 보냅니다./stop_profile엔드포인트를 호출하여 프로파일링을 종료하고 결과를 저장합니다.
1.3 추가 옵션
상세한 분석을 위해 다음 변수들을 profiler_config에 추가로 설정할 수 있습니다.
torch_profiler_record_shapes: 텐서의 Shape 정보를 기록합니다. (기본값: 꺼짐)torch_profiler_with_memory: 메모리 사용량을 함께 프로파일링합니다. (기본값: 꺼짐)torch_profiler_with_stack: 소스 코드의 스택 트레이스를 기록합니다. (기본값: 켜짐)torch_profiler_with_flops: FLOPs(Floating Point Operations)를 기록합니다. (기본값: 꺼짐)torch_profiler_use_gzip: 프로파일링 파일의 gzip 압축을 제어합니다. (기본값: 켜짐)
2. RBLN 프로파일러
RBLN Profiler는 RBLN NPU에서 실행되는 워크로드를 분석합니다. 자세한 내용은 RBLN 프로파일러에서 확인할 수 있습니다.
RBLN vLLM은 RBLN 프로파일러를 지원하며, PyTorch 프로파일러와의 연동도 함께 지원합니다.
2.1 설정
아래와 같이 환경 변수를 설정한 후 RBLN vLLM을 실행하면 프로파일링 결과가 생성됩니다.
RBLN_PROFILER=1: RBLN 프로파일러 활성화
이 환경 변수로 RBLN 프로파일러를 활성화합니다. RBLN 프로파일러는 vllm model implementation에서 동작하며, LLM에 model_impl="vllm"을 지정해 선택합니다. 이 경로에서 LLM에 profiler_config를 전달하지 않으면 RBLN 프로파일러가 단독으로 동작하여 자체 트레이스 파일을 생성합니다.
추가로 Rebel100™에서는 PyTorch 프로파일러와의 연동을 지원합니다. profiler_config에 "profiler": "torch"를 지정하면 PyTorch 프로파일러가 프로파일링 세션을 관리하며, RBLN 프로파일러의 트레이스가 PyTorch 프로파일러의 트레이스로 병합됩니다. 1번 항목에서 설명한 실행과 같습니다.
Note
측정 시간에는 프로파일링 데이터를 가져오는 오버헤드가 포함될 수 있어, 프로파일링을 끈 상태에서 측정한 실행 시간과 차이가 있을 수 있습니다. Device Workload를 비롯한 디바이스 실행 구간을 확인하는 용도로 활용하는 것을 권장합니다.
2.2 Offline Inference 프로파일링
start_profile()과 stop_profile()로 측정할 구간을 감쌉니다. 1번 항목과 동일한 vLLM 사용법을 따르며, RBLN 프로파일러는 RBLN_PROFILER=1로 활성화할 수 있습니다.
stop_profile()은 모든 워커가 트레이스 기록을 마친 뒤에 반환되므로, 반환된 시점에는 결과 파일이 디스크에 기록되어 있습니다.
Warning
측정 구간을 start_profile()과 stop_profile()로 감싸지 않으면 트레이스를 잃을 수 있습니다. 워커가 별도 프로세스에서 실행되는 구성에서는 엔진이 종료될 때 워커가 정리되며, 그 전에 기록되지 않은 트레이스는 남지 않습니다.
2.3 프로파일 결과 시각화
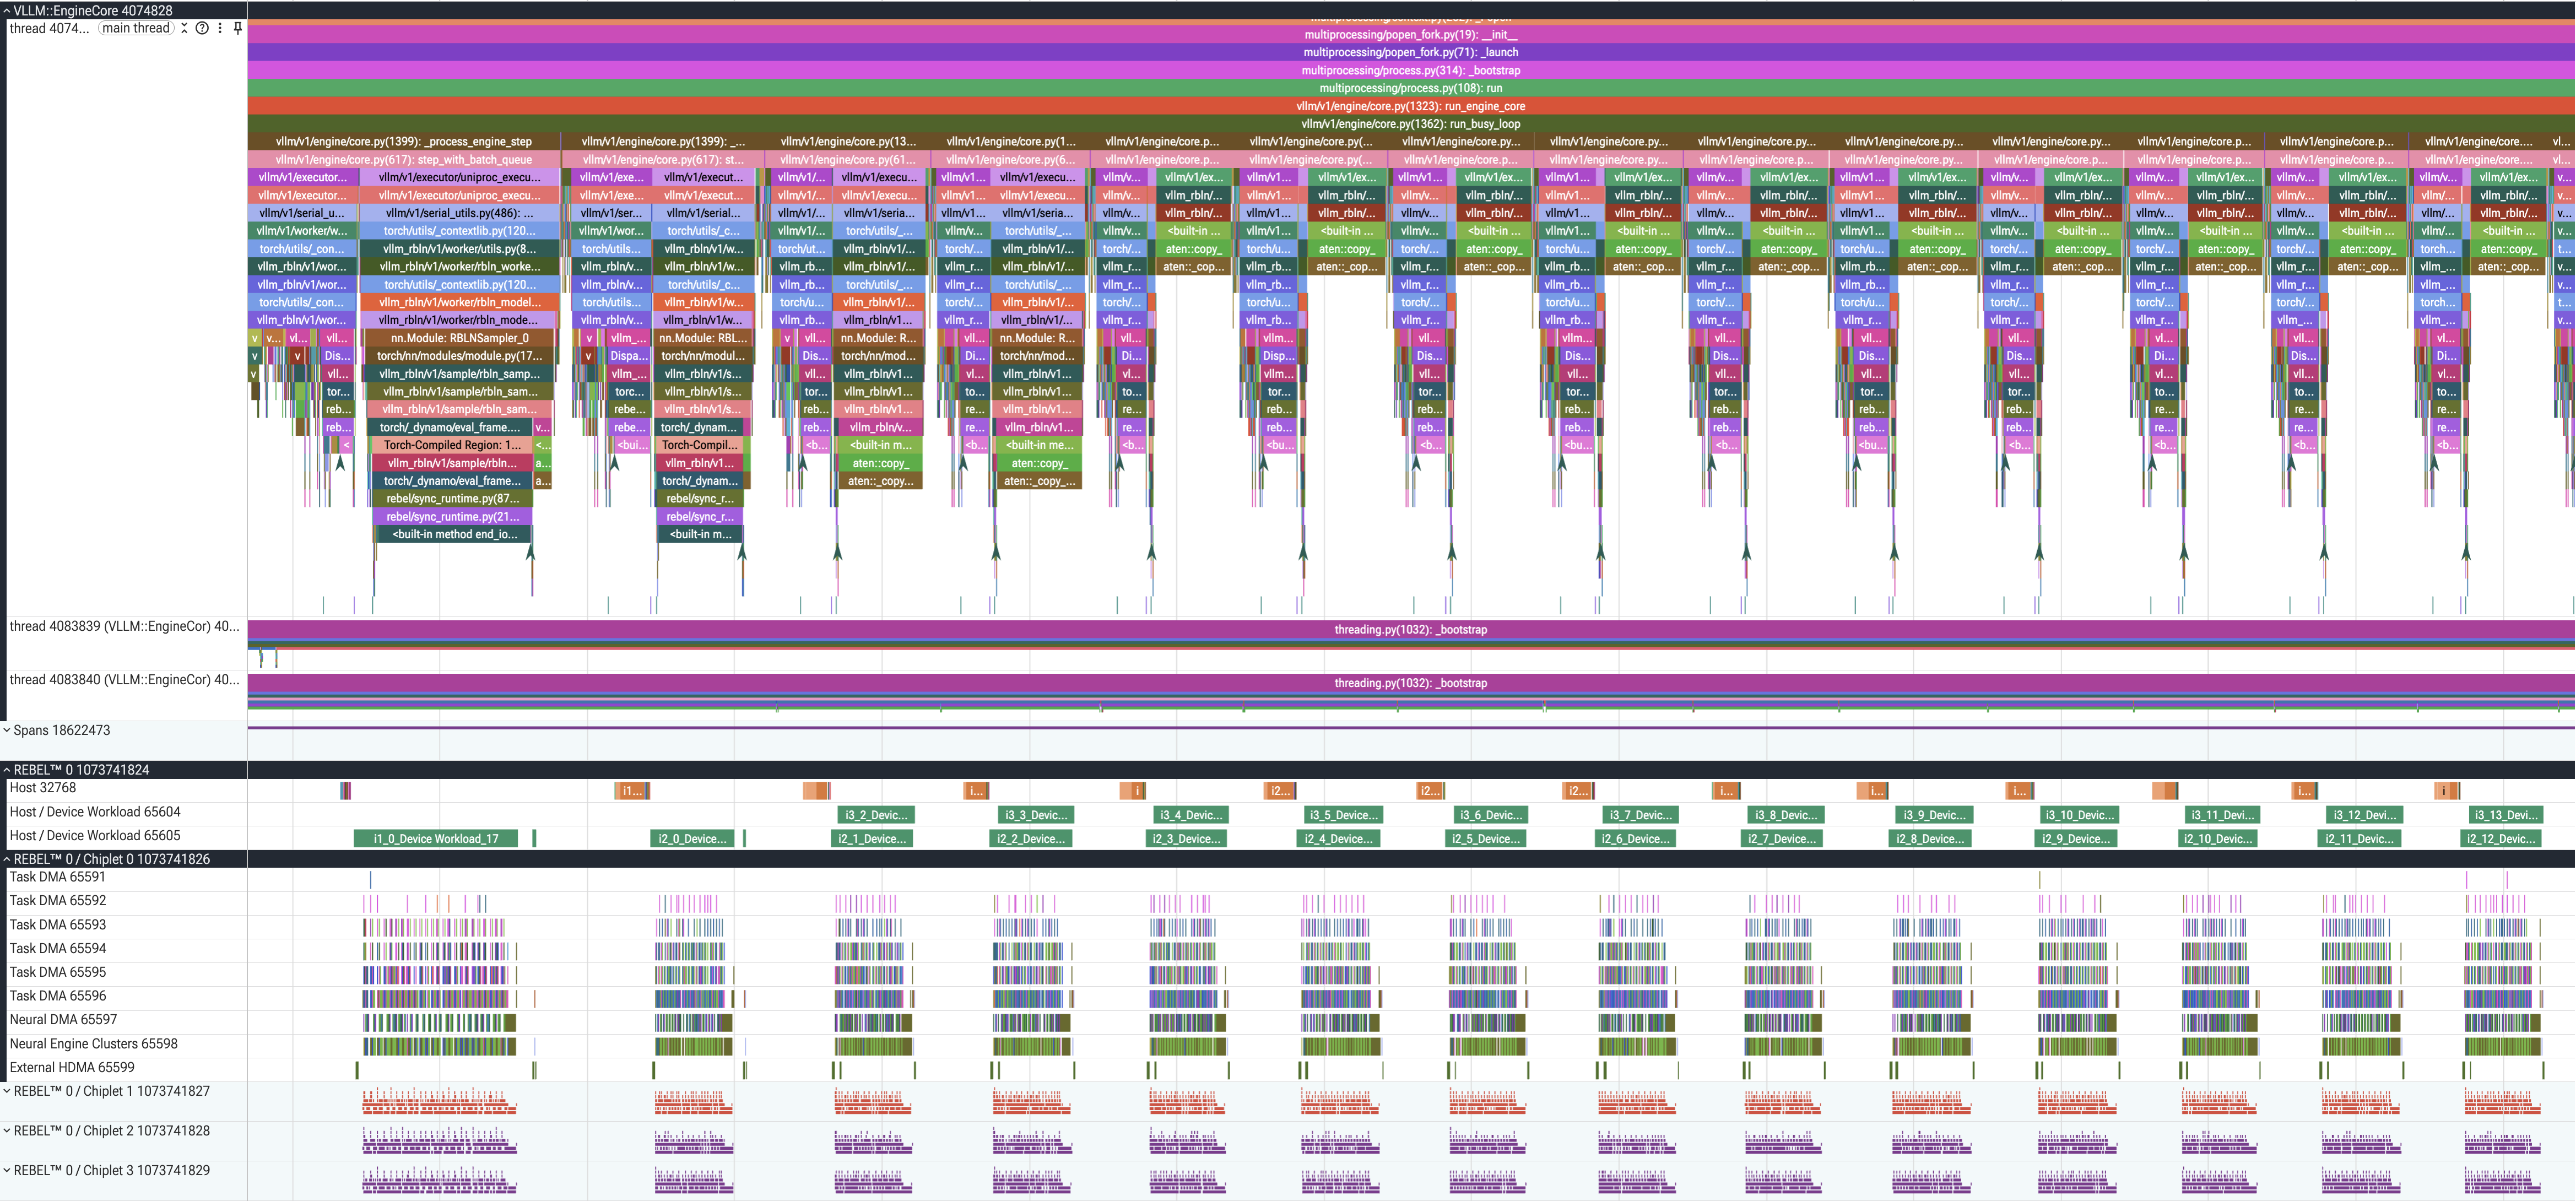
트레이스 파일은 워커마다 하나씩 생성되므로, 랭크가 여럿인 실행에서는 파일도 여럿 생성됩니다. 이 파일들도 Perfetto UI를 통해 시각화할 수 있습니다.
트레이스 분석에 대한 더 자세한 내용은 Perfetto 분석 방법 문서에서, vllm-rbln에서의 프로파일링 절차는 옵션 2: vllm-rbln을 사용하는 경우에서 확인할 수 있습니다.