Perfetto를 활용해 RBLN 프로파일러로 추출한 데이터를 분석하는 방법
이 페이지에서는 Perfetto UI 상에 나타나는 정보를 기반으로 프로파일링 결과를 분석하는 기초적인 방법을 설명합니다.
프로파일 정보에 대한 이해
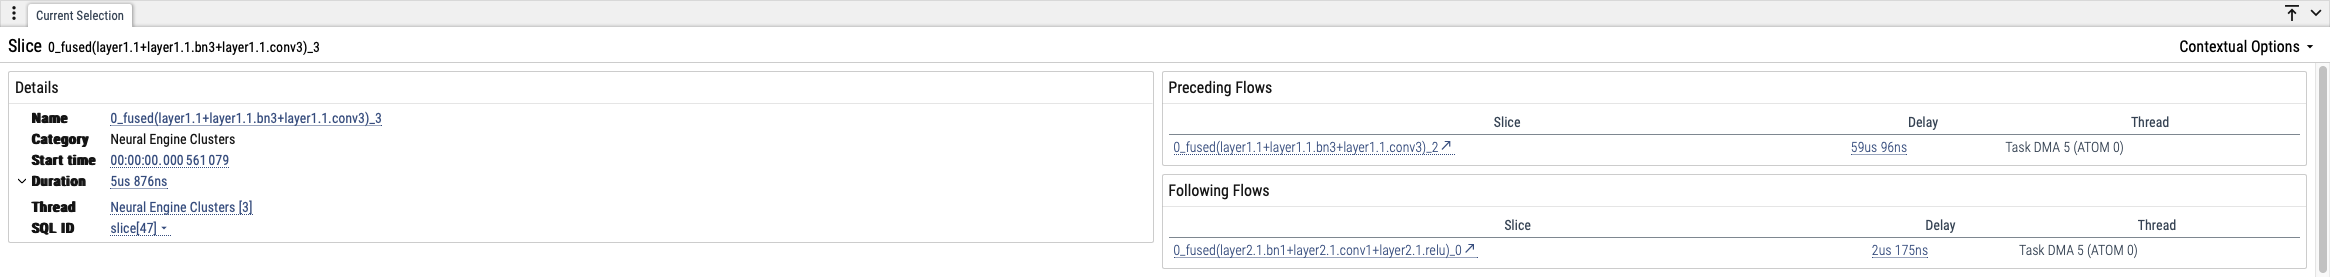
Task 세부 항목
-
이름 구조(Name)
RBLN 프로파일러는
i{instance_index}_{sequence_index}_W{workload_index}_{layer_name}_{command_index}와 같이 작업명을 구성합니다. 이러한 명명 규칙을 통해 인공 신경망 레이어의 특정 지점을 인식하고 해당 지점에서의 성능을 평가할 수 있습니다.i{instance_index}는 해당 명령어를 실행한 런타임 인스턴스를 나타냅니다. 여러 런타임 인스턴스의 기록을 하나로 합친Multi Stream파일에만 붙고,Single Stream파일에는 붙지 않습니다.sequence_index는 해당 런타임 인스턴스에서 모듈이 실행된 순서를 나타내며, 인스턴스마다 0부터 시작합니다. 따라서 기록이 합쳐진 파일에서는 앞의i{instance_index}와 함께 보아야 어느 실행인지 특정할 수 있습니다.W{workload_index}는 해당 명령어가 어느 런타임 호출(Device Workload슬라이스)에서 실행되었는지를 나타냅니다.Host명령어에는 붙지 않습니다. 자세한 내용은 Chiplet, Workload, CCL 트랙에 대한 이해에서 확인할 수 있습니다.layer_name은 특정한 텐서 수준 연산을 나타냅니다. 여러 개의 연산을 하나의 연산으로 합쳐서 처리할 경우, “fused()”라는 이름으로 하나의 그룹을 이루며 각 연산의 이름을 “+”로 연결합니다.command_index는 임의의 연산이 컴파일러에 의해 여러 개의 명령어로 나뉠 경우, 이 과정에서 생성된 명령어들을 구분하기 위해 사용합니다.
예를 들어
Multi Stream파일의i1_0_W2_fused(bn1+conv1+relu)_1은 런타임 인스턴스 1의 첫 번째 시퀀스에서Device Workload_2구간에 실행된,bn1,conv1,relu가 합쳐진 연산의 두 번째 명령어입니다. -
Task 목록(Category)
RBLN 프로파일러는 명령어를 아래의 Category로 분류합니다. 각 Task에 대한 자세한 정보는 RBLN NPU 아키텍처 페이지에서 확인할 수 있습니다.
HostNeural Engine ClustersNeural DMATask DMAExternal HDMADevice HDMADevice SyncGeneral Compute Engine
Perfetto UI에서는 명령어 이름 옆에 RBLN 프로파일러 내부에서 할당된 ID 값이 표시됩니다. 이 숫자들은 실제 RBLN NPU의 성능과는 관련이 없습니다.
-
의존성 연결(
Preceding Flows&Following Flows)Perfetto UI 상 아래쪽에 위치한
Preceding Flows와Following Flows는 명령어 간 의존성을 나타냅니다. 모델 컴파일 과정에서 이러한 의존성은 Command Processor가 디바이스의 구성과 할당 상태를 고려하여 적절히 처리하도록 결정됩니다.Neural DMA와 관련된 의존성은 Neural Engine 내부의 Task Manager에서 관리하기 때문에, 이에 해당하는 의존성은 Perfetto 상에 표시되지 않습니다.-
External HDMA와Task DMA사이의 의존성
External HDMA는 호스트 DRAM에서 디바이스 메모리로 가중치와 입력 데이터를 전송하는데, 이 과정에서 디바이스 메모리로부터 칩 내부 Shared Memory로 데이터를 전송하는Task DMA와 의존성을 형성합니다. 이와 유사하게,Task DMA를 통해 디바이스 메모리로 전송되는 최종 출력 데이터는External HDMA를 통해 호스트 DRAM으로 전송해야 합니다. 따라서External HDMA를 반드시Task DMA이후에 수행해야 한다는 의존성을 지키는 것이 매우 중요합니다.이러한 시각화된 흐름은 명령어 간의 명시적인 의존성을 나타냅니다. 하지만, 이것이 꼭 이러한 연결이 없는 명령어에는 의존성이 없다는 것을 의미하지는 않습니다. 예를 들어, 각 Neural Engine 내부의 Task Manager는 단일 하드웨어 수준에서의 의존성을 관리합니다. 또한, 첫 번째
Neural Engine Clusters명령어를 이와 관련된External HDMA가 끝난 후에 동작하도록 하는 장벽(barrier)도 존재합니다. -
Neural Engine Clusters와Task DMA사이의 의존성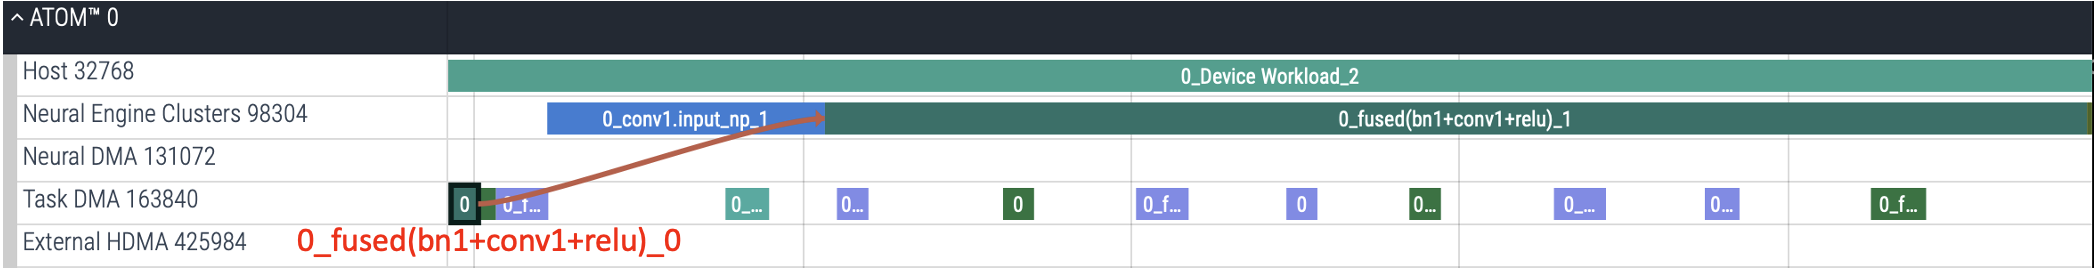
Neural Engine Clusters와Task DMA사이의 연결은 주로 가중치 또는 신경망의 레이어 간 입/출력을 전송하는 것과 관련이 있는 의존성을 보여주며, 이 연결에 따라 작업을 수행하도록 고안되었습니다. 위 예시에 표시된 의존성은0_fused(bn1+conv1+relu)_1연산을 처리하기 위해 이때 필요한 가중치를Neural Engine Clusters에 불러와야 함을 나타내고, 이러한 의존성은 컴파일러에 의해 결정됩니다. 또한, 만약 컴파일러에서Neural Engine Clusters와Task DMA사이를 연결해야 한다고 판단한다면 이것을 의존성이 필요한 상황이라고 간주합니다. 예를 들어, 인공 신경망 레이어들의 연산 이후에 생성된 데이터가 그 크기 때문에 임시적으로 디바이스 메모리에 저장되는 상황이 이에 해당합니다. -
Device HDMA와Device Sync사이의 의존성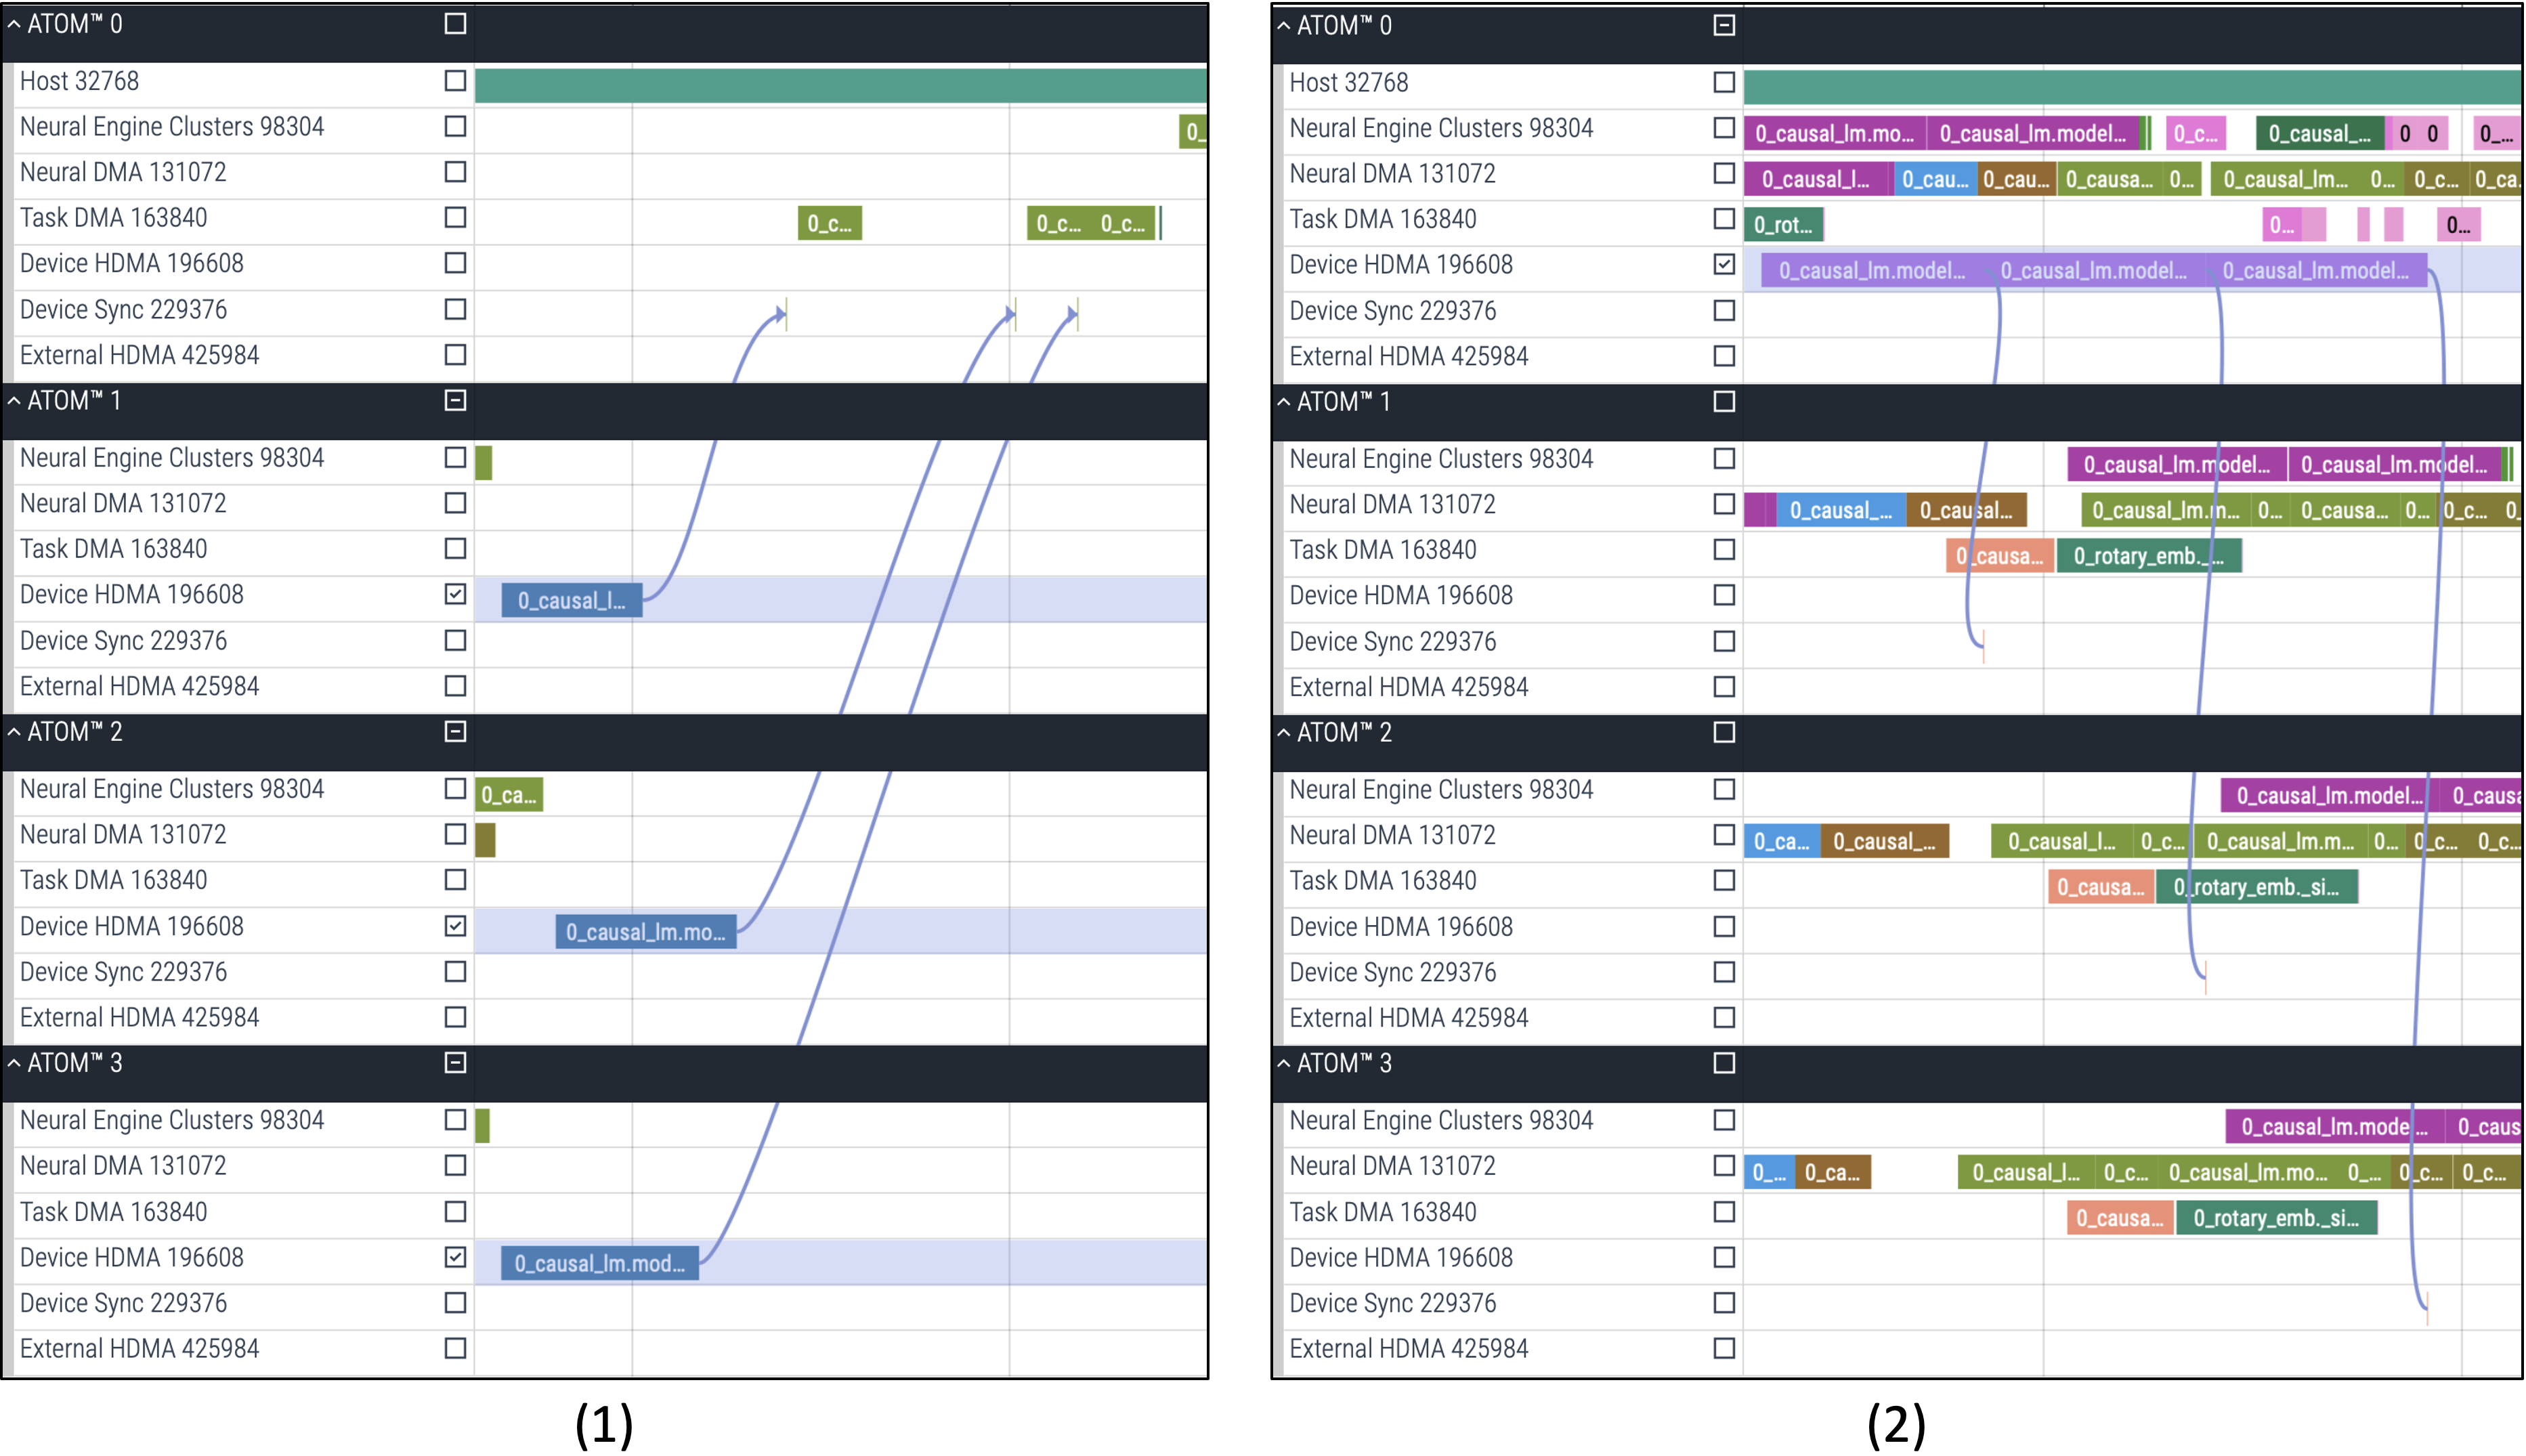
여러 대의 디바이스를 사용하는 대규모 모델의 경우 샤딩(sharding)을 통해 신경망 레이어들을 조각내어 여러 디바이스에서 실행할 수 있도록 합니다.
첫 번째 상황에서는 루트(root) 디바이스(node 0)가
Device HDMA를 통해 데이터를 받는 과정에서 리프(leaf) 디바이스들(node 1, 2, 3)과 동기화합니다.그림 (1)에서는 위 과정에서 데이터가Device HDMA를 통해 루트 디바이스(node 0)로 모이는 과정을 보여줍니다. 이후 각 리프 디바이스(node 1, 2, 3)의 동기화가 해제됩니다.두 번째 상황에서는 이와 반대로 루트 디바이스(node 0)가
Device HDMA를 통해 데이터를 보내는 상황에서 리프 디바이스들(node 1, 2, 3)과 동기화합니다.그림 (2)에서는 데이터가Device HDMA를 통해 각각의 리프 디바이스로 전송되는 과정을 보여줍니다. 그 후, 각 리프 디바이스는 데이터를 제대로 받았음을 확인하기 위해 동기화 신호를 보냅니다.이러한 텐서 병렬화 모델에서는 컴파일 과정에서
Device HDMA에 대한 의존성을 확인하기 위해 동기화 명령어가 생성됩니다.Note
ATOM™: 위 스크린샷은 ATOM™ 트레이스입니다. 디바이스 간 데이터 전송과 동기화는
Device HDMA와Device Sync명령어로 표시됩니다.Rebel100™:
Device HDMA와Device Sync명령어는 각Chiplet그룹 안에 표시됩니다. RBLN vLLM의 텐서 병렬 서빙처럼 집합 통신(CCL)을 사용하는 경우에는 디바이스 간 통신이CCL트랙에 표시됩니다. 자세한 내용은 CCL 통신에서 확인할 수 있습니다.
-
Chiplet, Workload, CCL 트랙에 대한 이해
Rebel100™ 트레이스는 명령어를 칩렛 단위로 묶고, 트레이스 구조에서 설명한 Device Workload 트랙과 CCL 트랙을 제공합니다. 이 절에서는 이 트랙들을 읽는 방법을 설명합니다. RBLN vLLM에서 프로파일링을 사용하면 랭크별 트레이스에 비동기 Device Workload 구간과 CCL 구간이 프레임워크 수준 연산과 함께 표시되어, 아래에서 설명하는 트랙들을 더 뚜렷하게 확인할 수 있습니다. 자세한 내용은 옵션 2: vllm-rbln을 사용하는 경우에서 다룹니다.
Device Workload 대응
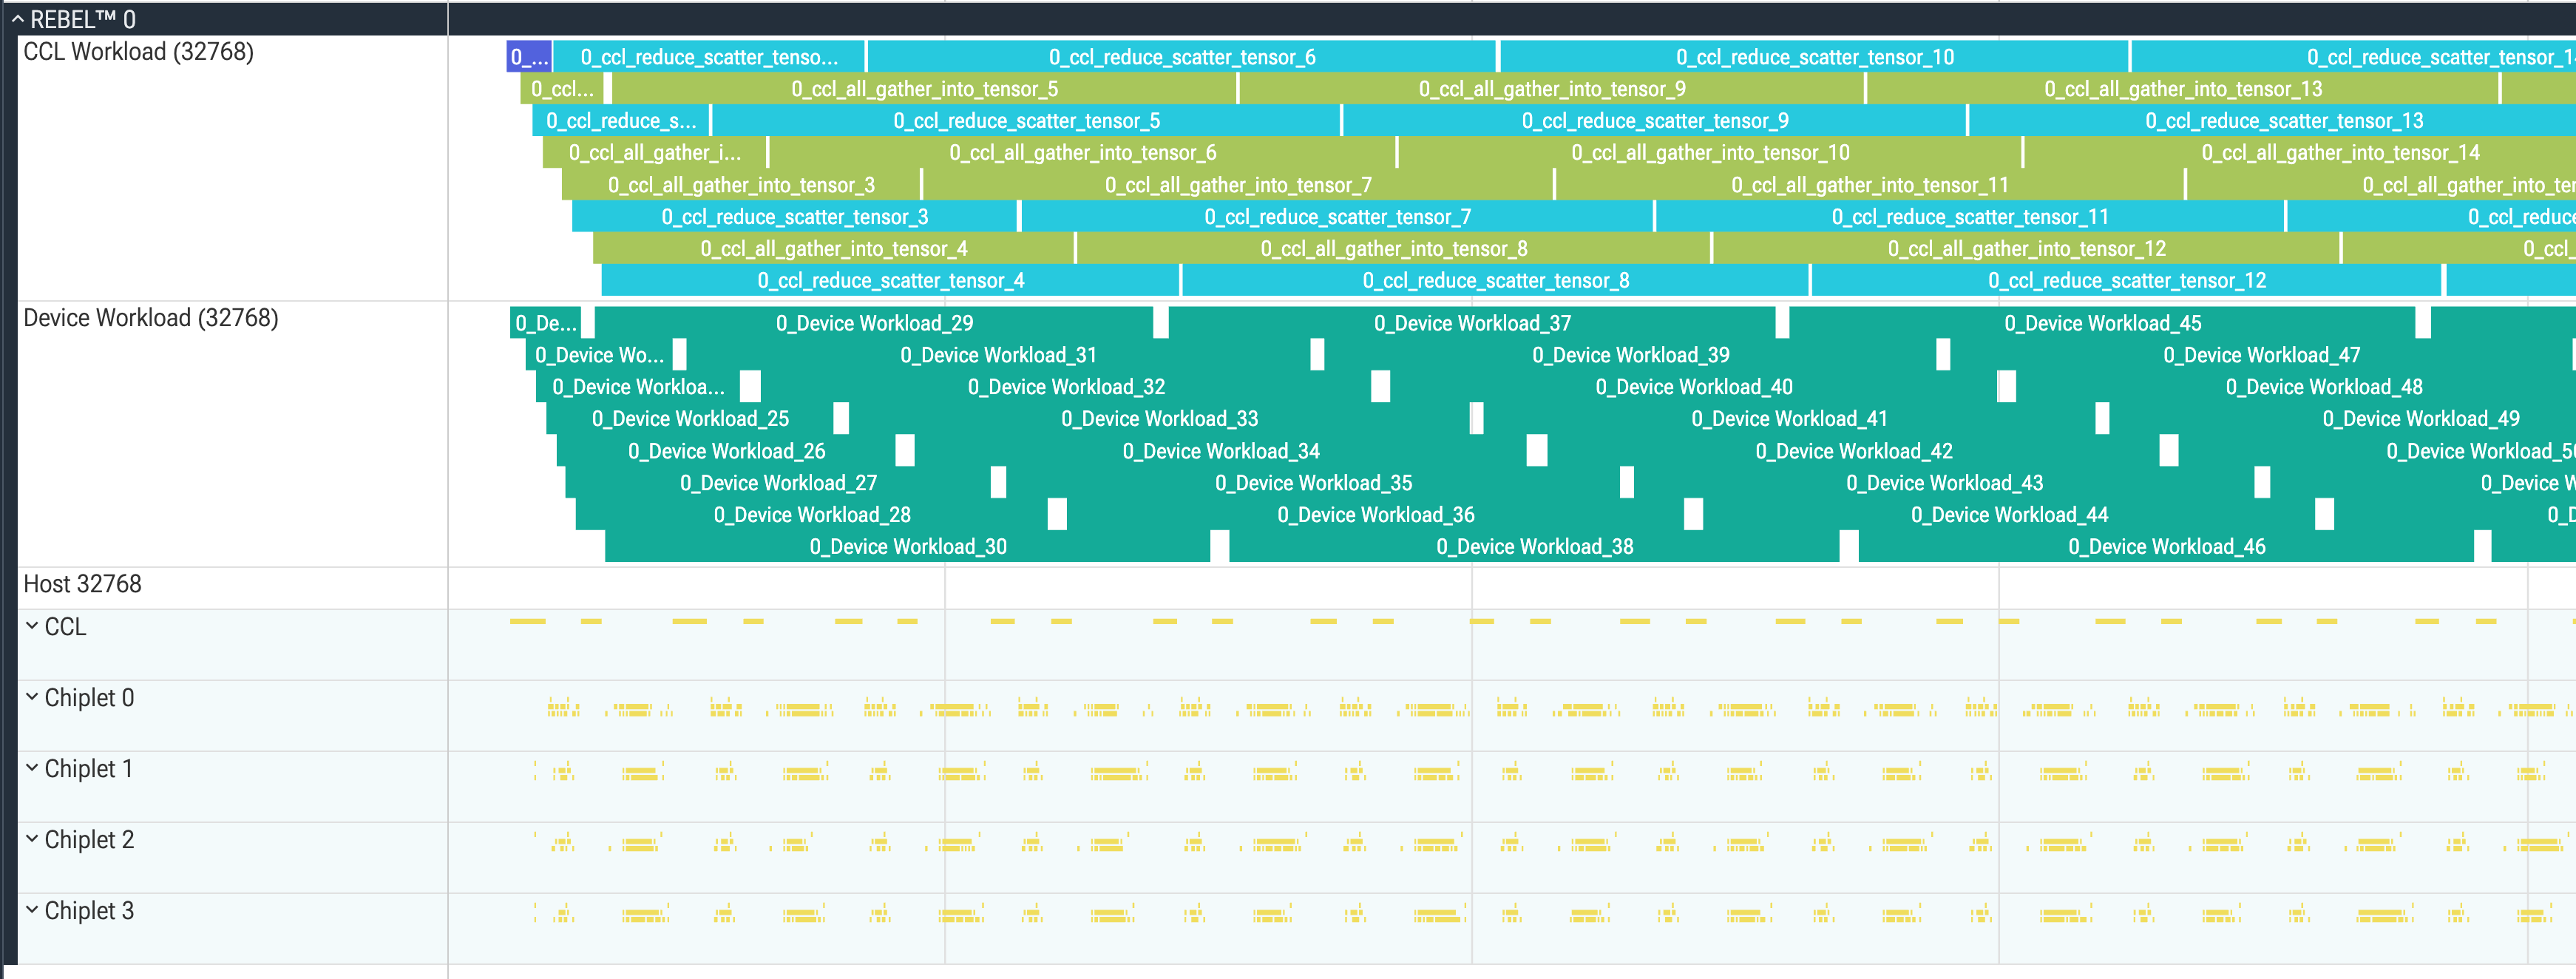
Device Workload 트랙의 슬라이스 이름은 {sequence_index}_Device Workload_{workload_index} 형식이며(Multi Stream 파일에서는 명령어와 같이 i{instance_index}_ 접두어가 붙음), 각 슬라이스는 런타임 호출 한 건의 디바이스 측 실행 구간을 나타냅니다. 위 그림처럼 연속된 런타임 호출의 실행 구간이 중첩되면 Device Workload 슬라이스가 트랙 안에서 여러 행으로 표시됩니다.
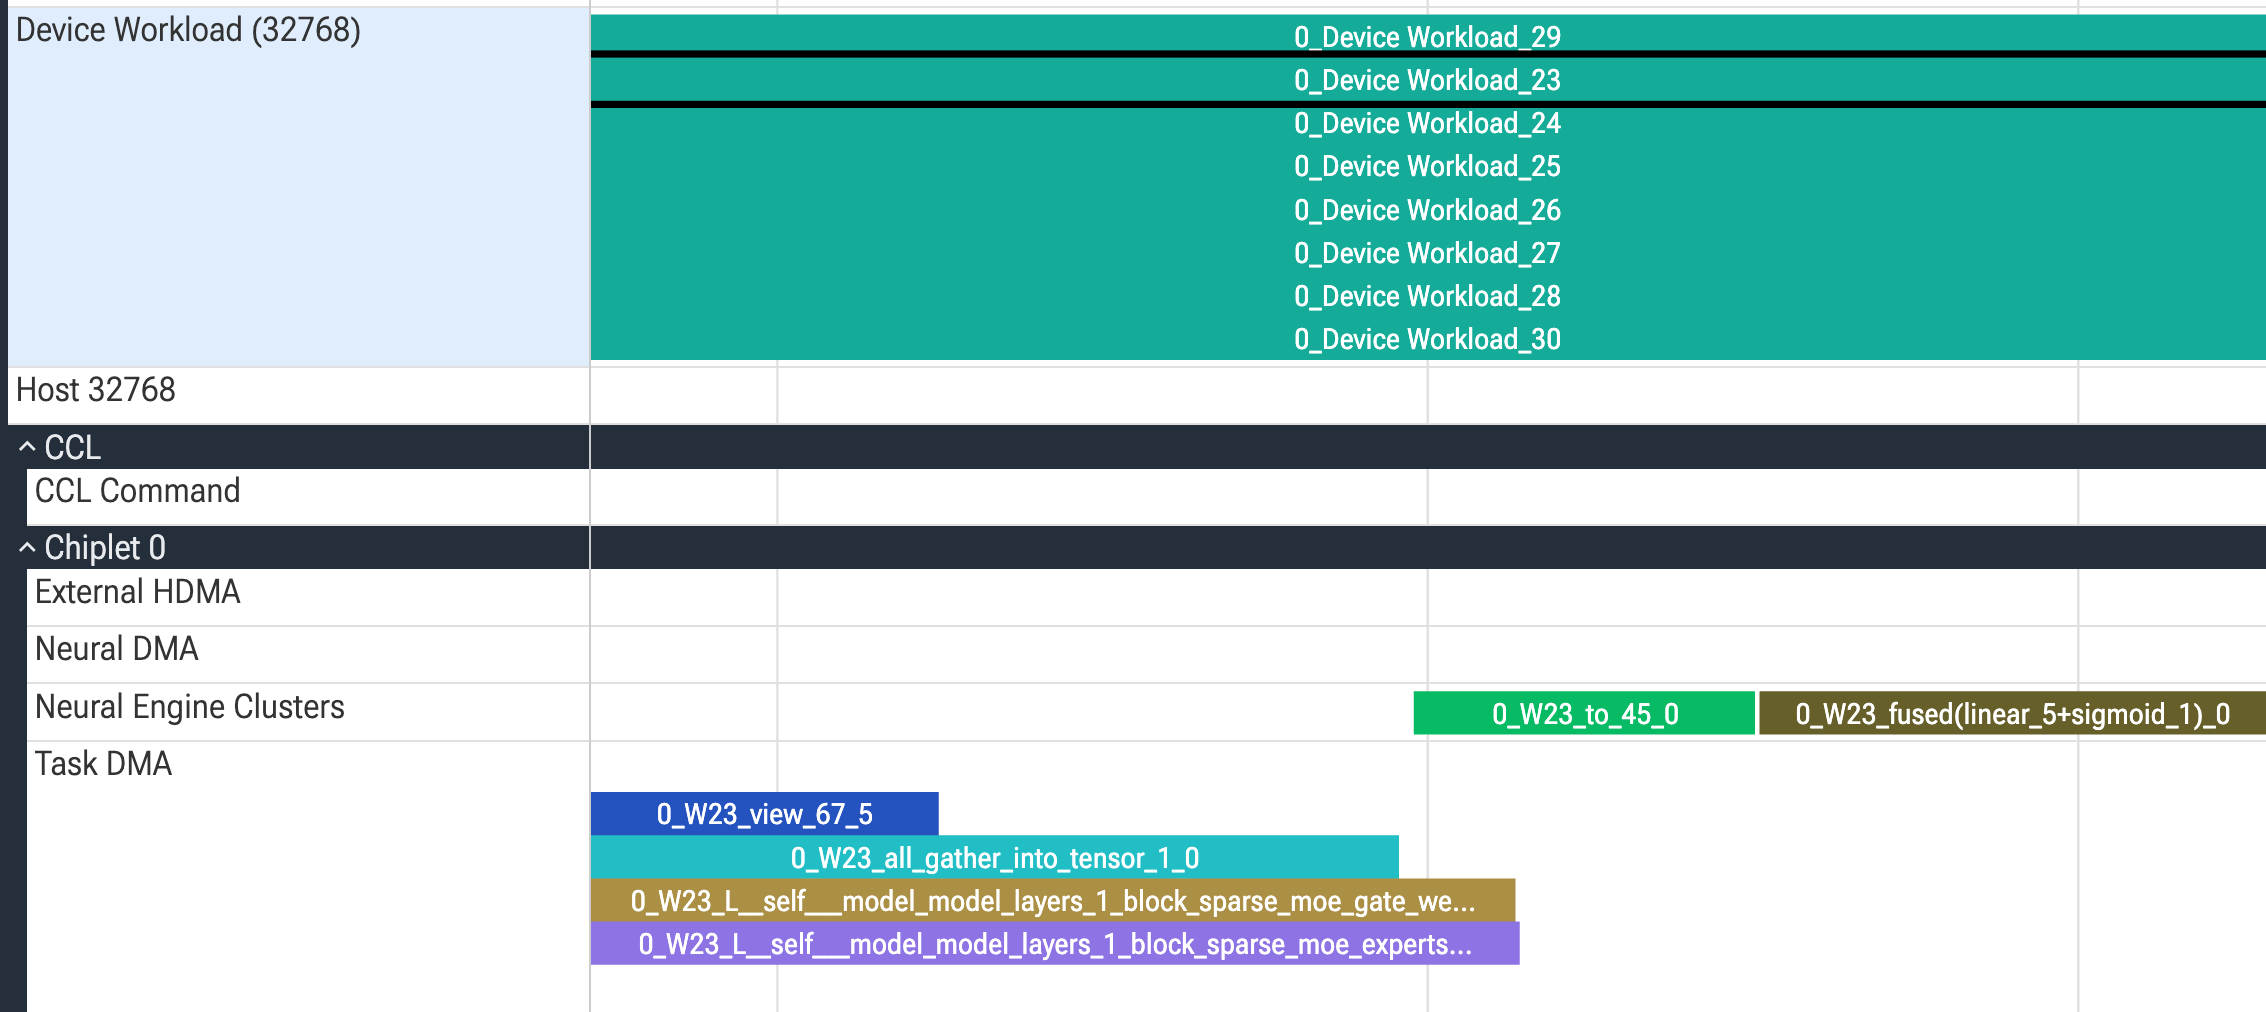
구간에 속한 명령어의 이름에는 이에 대응하는 W{workload_index} 토큰이 포함되므로, 트레이스에서 이 토큰을 검색하면 해당 명령어들을 확인할 수 있습니다. 위 그림은 Device Workload_23 구간을 선택하고, 이름이 0_W23_로 시작하는 명령어들이 Chiplet 0의 Neural Engine Clusters와 Task DMA 트랙에서 실행된 모습을 보여줍니다. 실행 구간이 중첩되더라도 각 호출의 명령어는 이 workload_index로 구분됩니다.
Chiplet 그룹
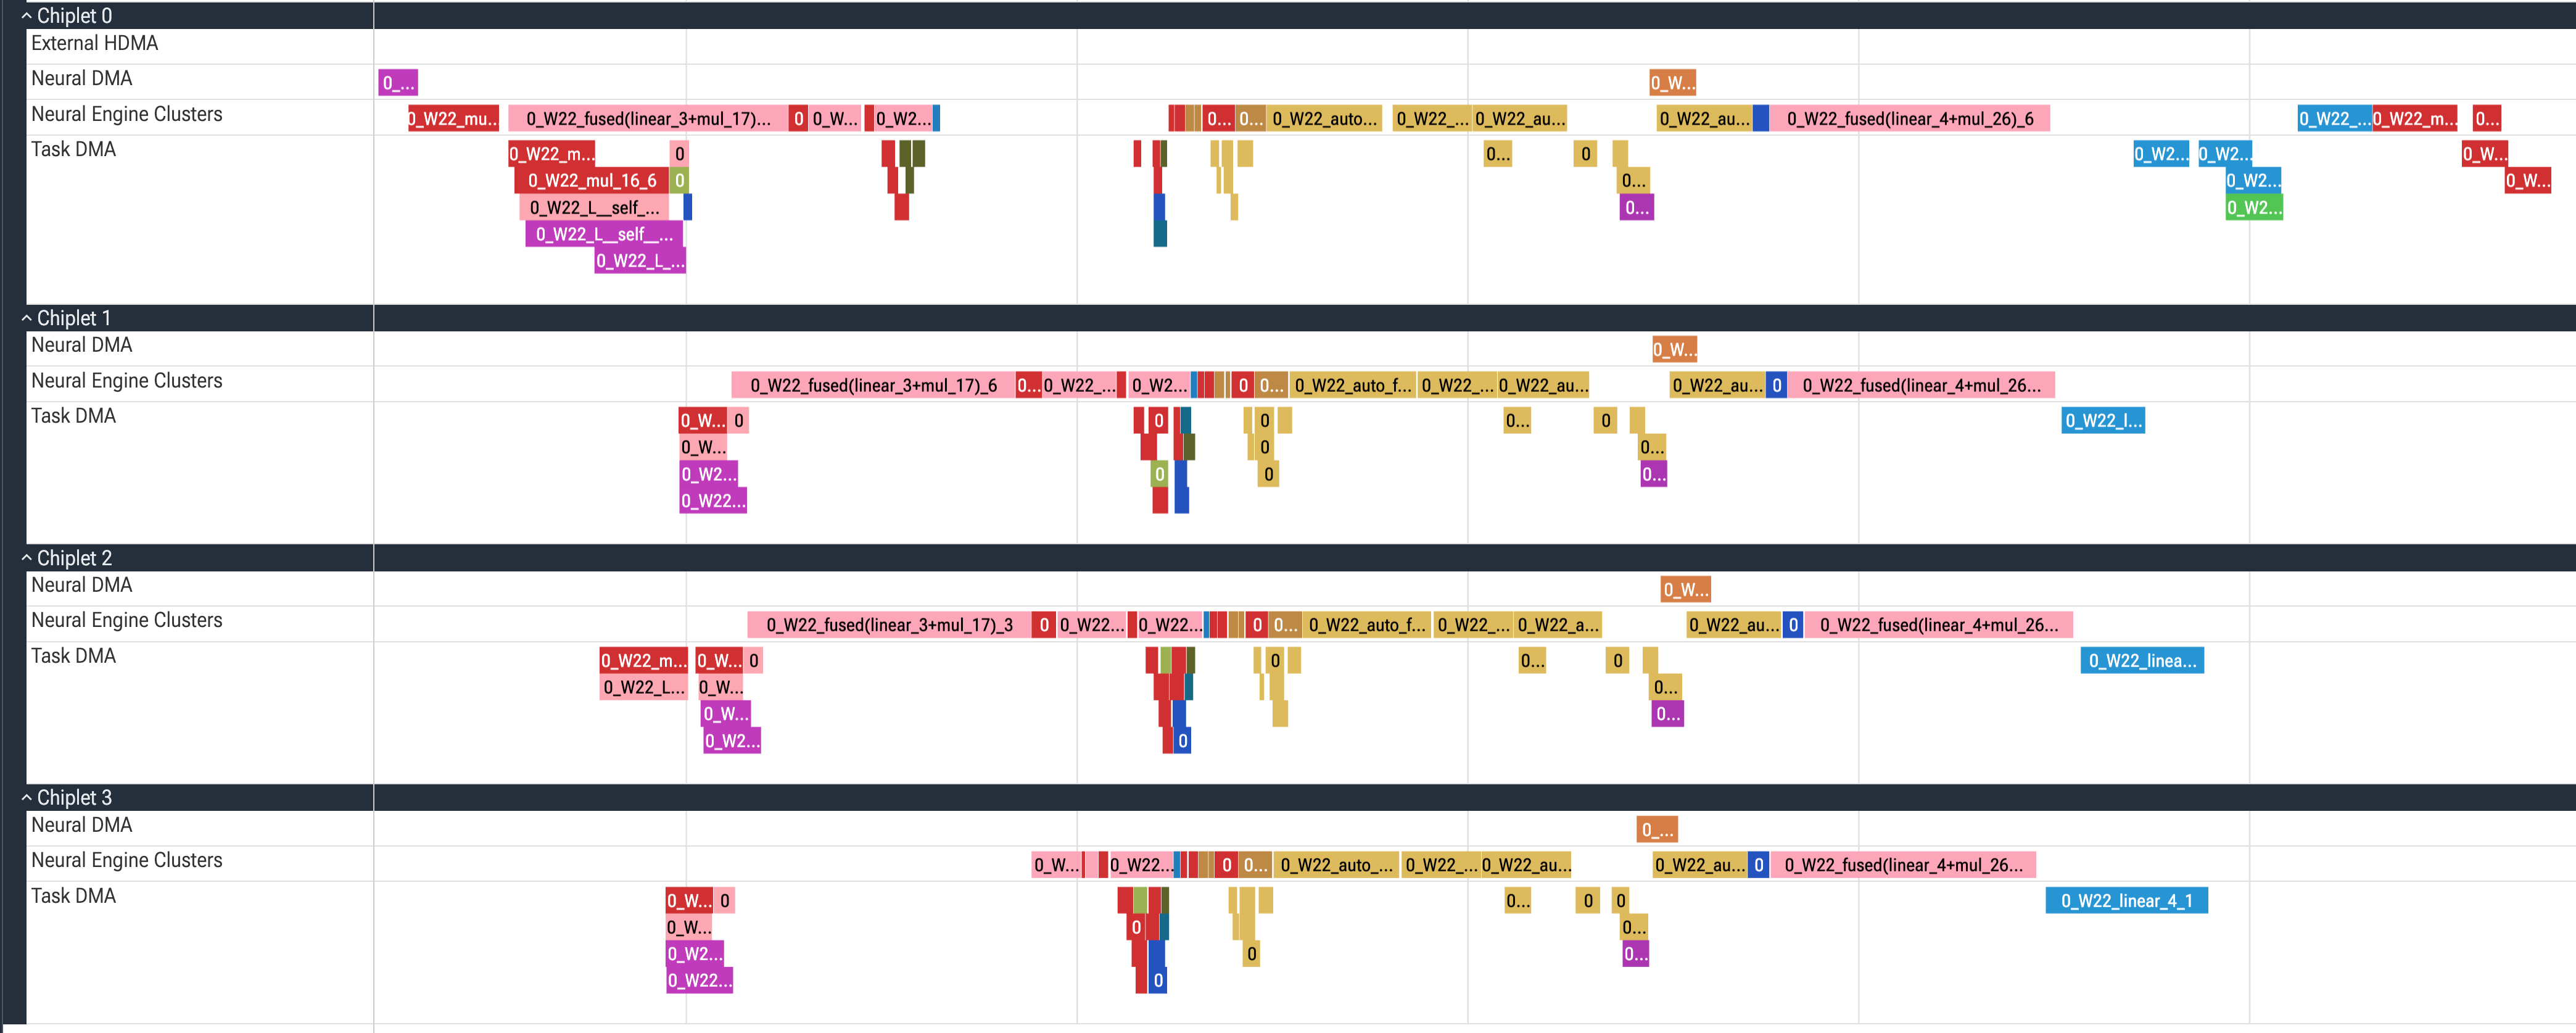
명령어는 이를 실행한 칩렛의 Chiplet 그룹에 기록되므로, 명령어가 어느 칩렛에서 실행되었는지는 이 그룹으로 확인합니다. 여러 칩렛에 분산된 레이어는 같은 이름의 명령어가 여러 Chiplet 그룹에 나타나며, 각 슬라이스는 해당 칩렛이 실행한 부분에 해당합니다. Rebel100™은 칩렛 4개로 구성되므로 Chiplet 0부터 Chiplet 3까지 네 그룹이 모두 표시되며, 슬라이스가 없는 그룹은 해당 칩렛이 프로파일링 대상 모델의 명령어를 실행하지 않았음을 의미합니다.
Note
ATOM™은 단일 다이 SoC이므로 ATOM™ 트레이스에는 Chiplet 그룹이 없습니다.
CCL 통신
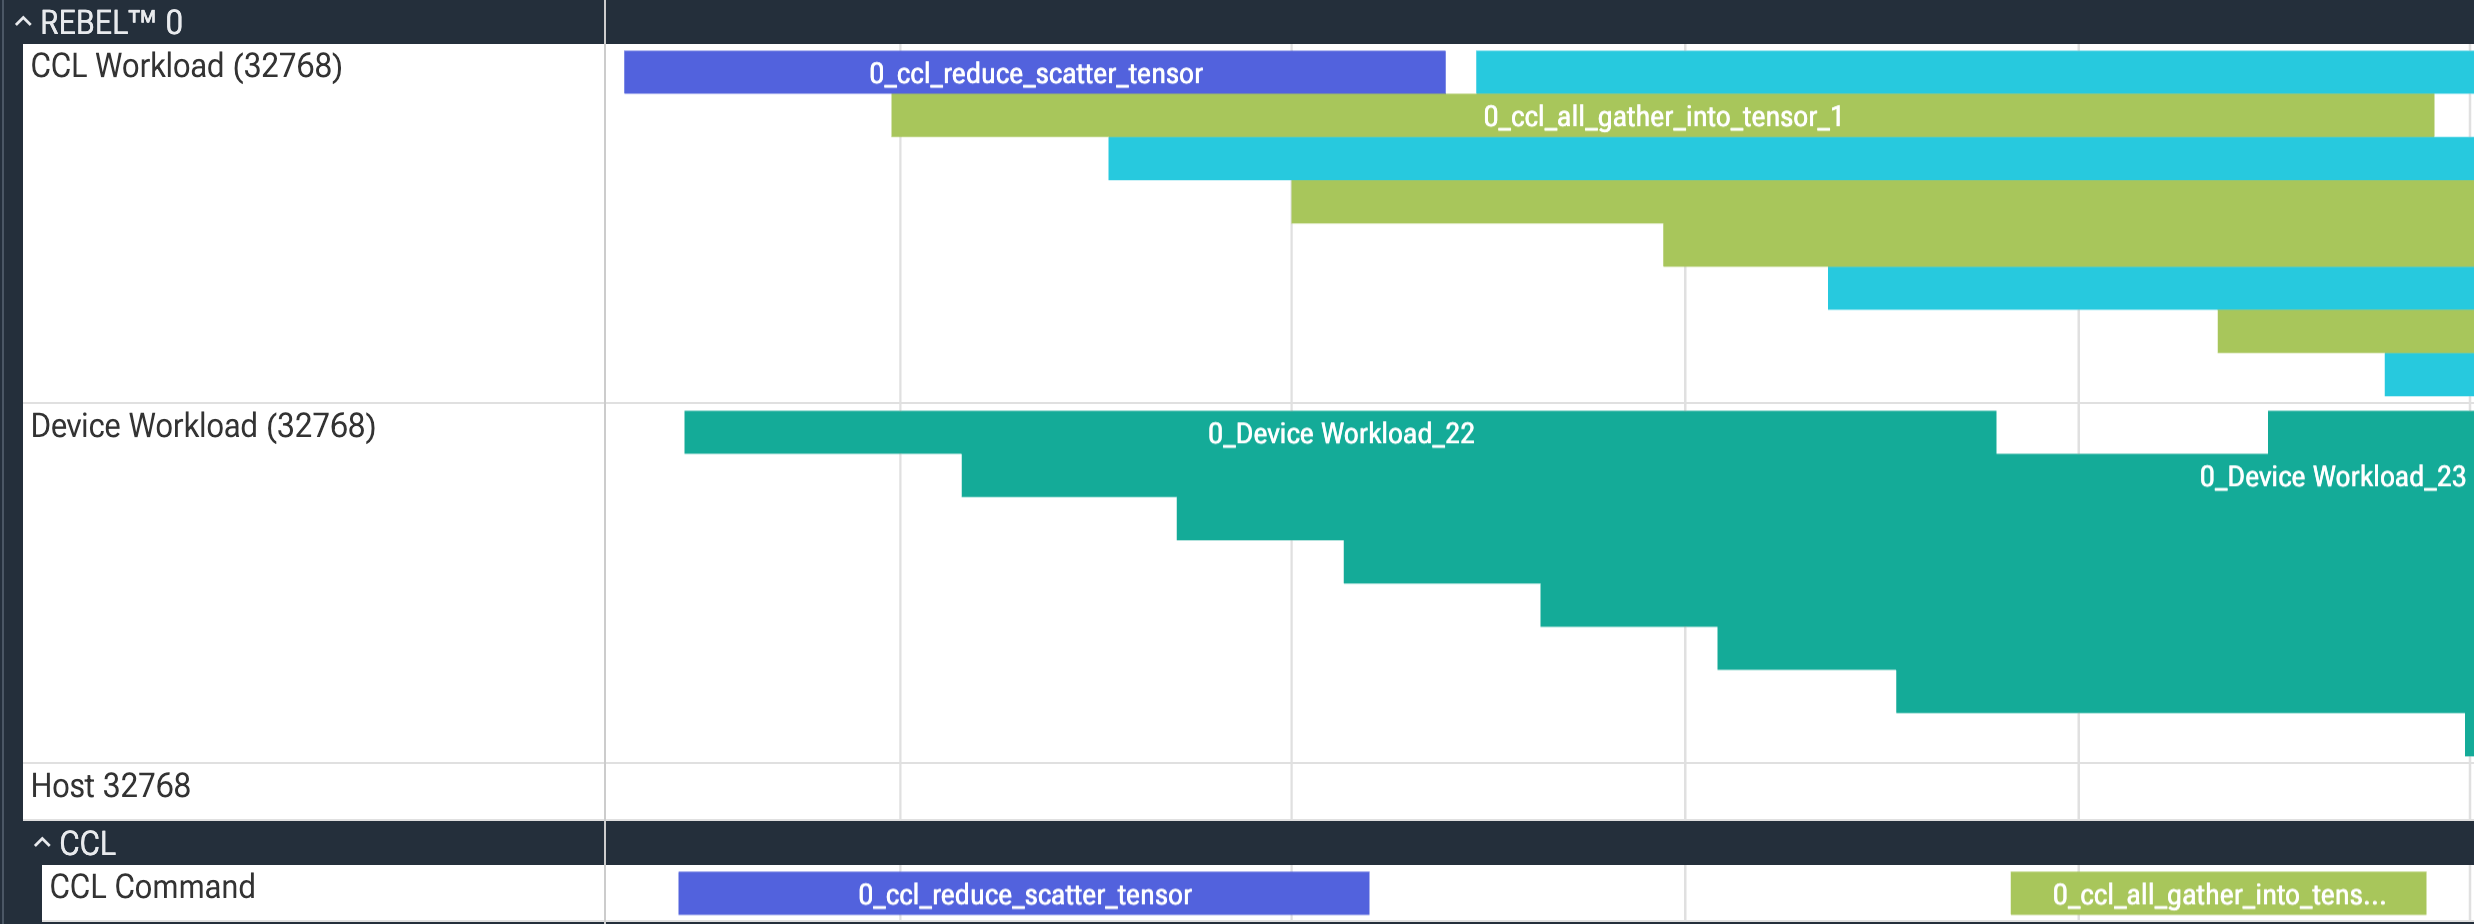
RBLN vLLM의 텐서 병렬 서빙처럼 집합 통신(collective communication, CCL)을 사용하여 모델을 여러 Rebel100™ 디바이스에서 실행하면, 집합 통신 연산이 트레이스에 전체 실행 구간과 명령어 스트림 실행 구간으로 구분해 표시됩니다. 집합 통신을 사용하지 않는 실행에서는 CCL 트랙이 생성되지 않습니다. 디바이스 레벨의 CCL Workload 트랙에는 집합 통신 한 건마다 전체 실행 구간을 나타내는 슬라이스가 하나씩 있습니다. CCL 그룹을 펼치면 CCL Command 트랙이 나타나며, 여기서 같은 이름의 슬라이스는 해당 집합 통신의 명령어 스트림이 실행된 구간만을 나타냅니다.
프로파일링 오버헤드

Host 트랙에는 Profile Wait, Profile Readback, Profile Workload 슬라이스도 표시됩니다. 위 그림은 Profile Readback 슬라이스가 표시된 경우입니다. 이 슬라이스들은 RBLN 프로파일러가 런타임 호출의 완료를 기다리고 디바이스에서 카운터를 읽어 오는 데 쓴 시간을 나타냅니다. 모델의 지연 시간을 측정할 때는 이 슬라이스들을 제외해야 합니다. 프로파일링을 비활성화하면 존재하지 않는 구간입니다.
상세 명명 규칙
인공 신경망을 실행하는 것은 일련의 텐서 연산으로 표현할 수 있고, RBLN 컴파일러를 통해 각 텐서 연산은 몇 개의 명령어로 나타낼 수 있습니다. 따라서, 시각화된 프로파일링 결과 상에서 일련의 명령어들은 인공 신경망의 모듈 한 개와 연결하여 생각할 수 있습니다. 이 절에서는 타임라인에서 각 명령어의 명명 규칙에 대해 간략하게 설명합니다.
상황 1. 모델의 레이어 이름과의 연결(파이토치)
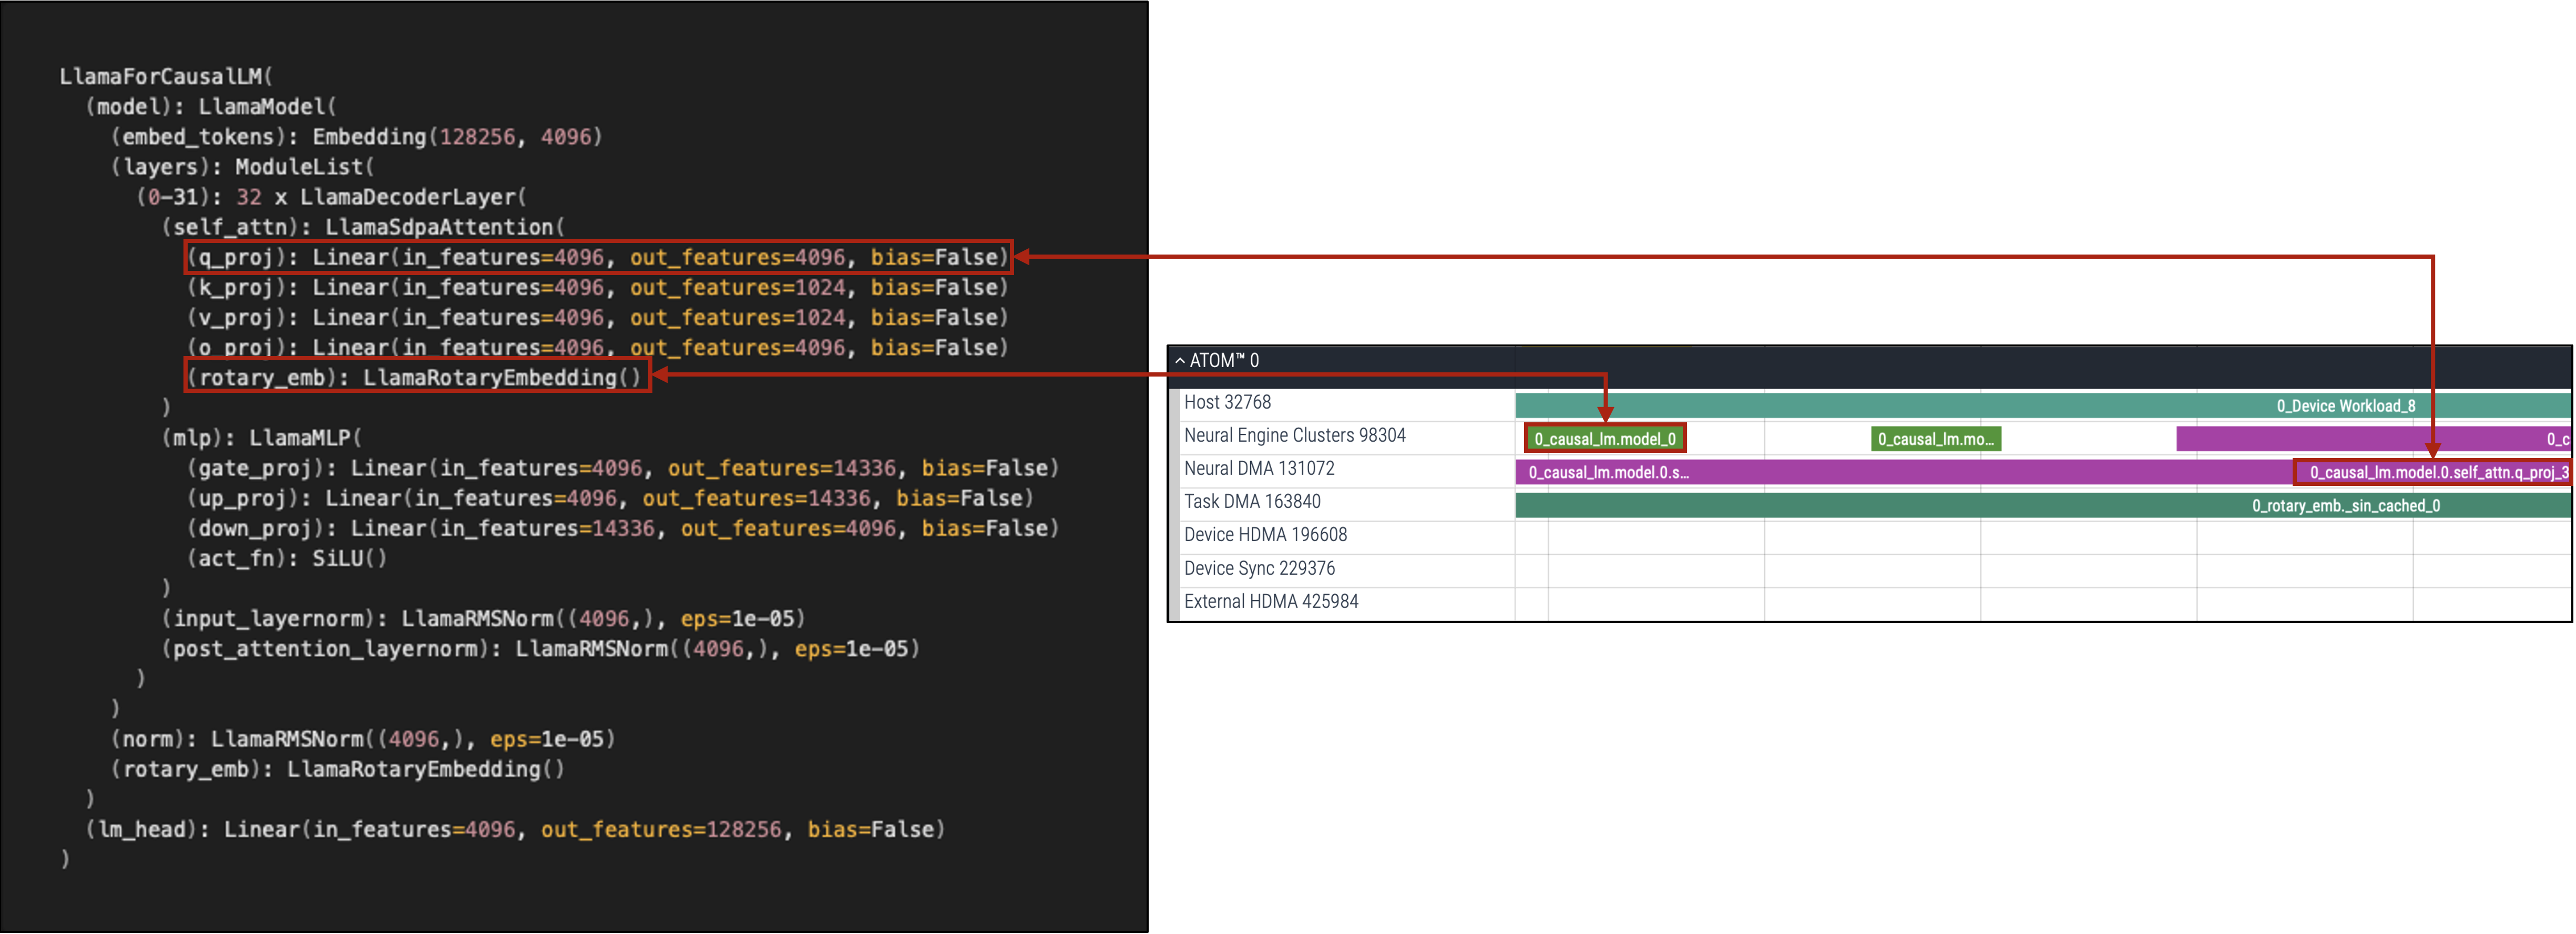
모델의 구조는 해당 모델의 구조를 출력하거나 그 구현부를 확인하는 것으로 알 수 있습니다. 이 정보를 Perfetto 상에서 시각화된 명령어들과 비교하면 특정 연산이 어떻게 일련의 명령어들로 변환되었는지를 확인할 수 있습니다. 위 예시를 보면, LlamaForCausalLM의 model.layers[0].self_attn.q_proj는 Perfetto 상에서 0_causal_lm.model.0.self_attn.q_proj와 같이 표현됩니다.
모델의 구조 및 레이어들의 순서는 실제 명령어가 처리되는 순서와 차이가 있을 수 있습니다. 몇몇 명령어들은 컴파일 과정에서 생략될 수 있고, 이러한 경우 단일 레이어의 command index가 끊어진 것처럼 보입니다. 또한, 여러 연산들을 RBLN NPU에서 효율적으로 실행하기 위해 컴파일 과정에서 별도의 명령어들이 추가될 수도 있습니다. 위 예시에서는 내부의 rotary positional embedding(RoPE) 레이어를 처리하기 위해 0_causal_lm.model_0가 새로 추가되었음을 확인할 수 있습니다.
상황 2. 명령어 생성
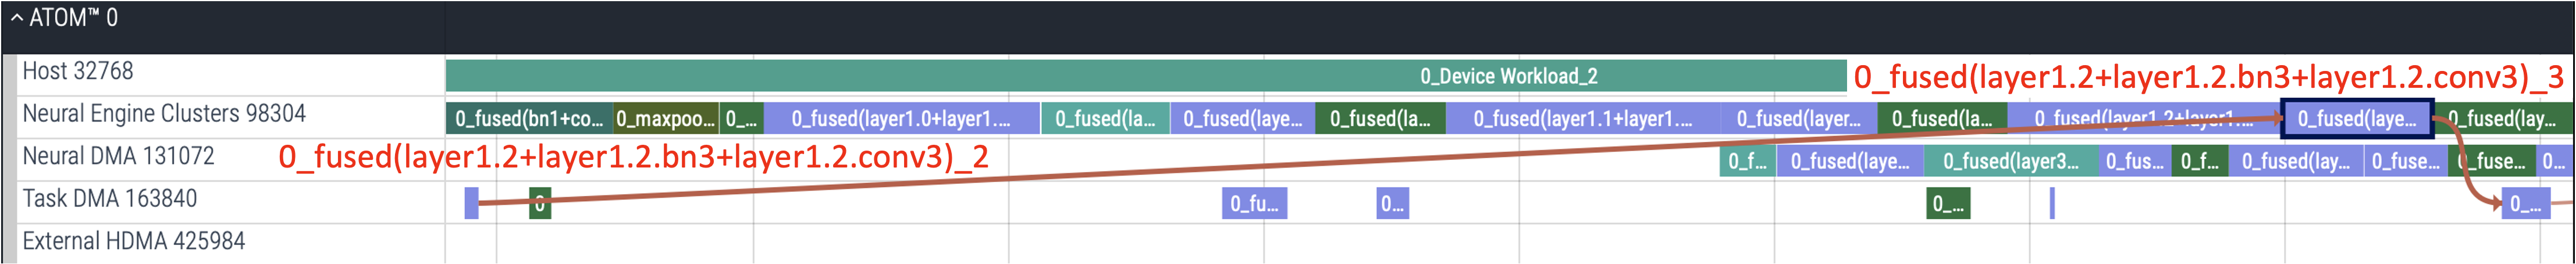
RBLN 컴파일러는 성능과 효율성 개선을 위해 연속된 연산들을 하나의 함수로 합치는 연산결합(operation fusion)을 지원합니다. 합쳐진 함수의 command_name은 fused(name0+name1...)과 같은 형태를 가집니다. 위 예시에서는 합성곱(convolution) 레이어와 배치 정규화(batch normalization) 레이어, 활성화 함수 레이어가 fused(layer1.2+layer1.2.bn3+layer1.2.conv3)라는 이름의 함수로 합쳐진 것을 보여줍니다.
단일 모듈을 처리하기 위한 명령어들은 동일한 command_name을 공유하고, 이들 각각은 command_index를 통해 구분할 수 있습니다. 위 예시에서 fused(layer1.2+layer1.2.bn3+layer1.2.conv3) 연산을 실행하기 위해 Task DMA를 통해 메모리에 접근하거나 Neural Engine Clusters에서 연산을 처리하는 등의 명령어들은 0_fused(layer1.2+layer1.2.bn3+layer1.2.conv3)_{command_index}와 같은 형태를 갖습니다.
상황 3. 레이어 내 재활용(파이토치)
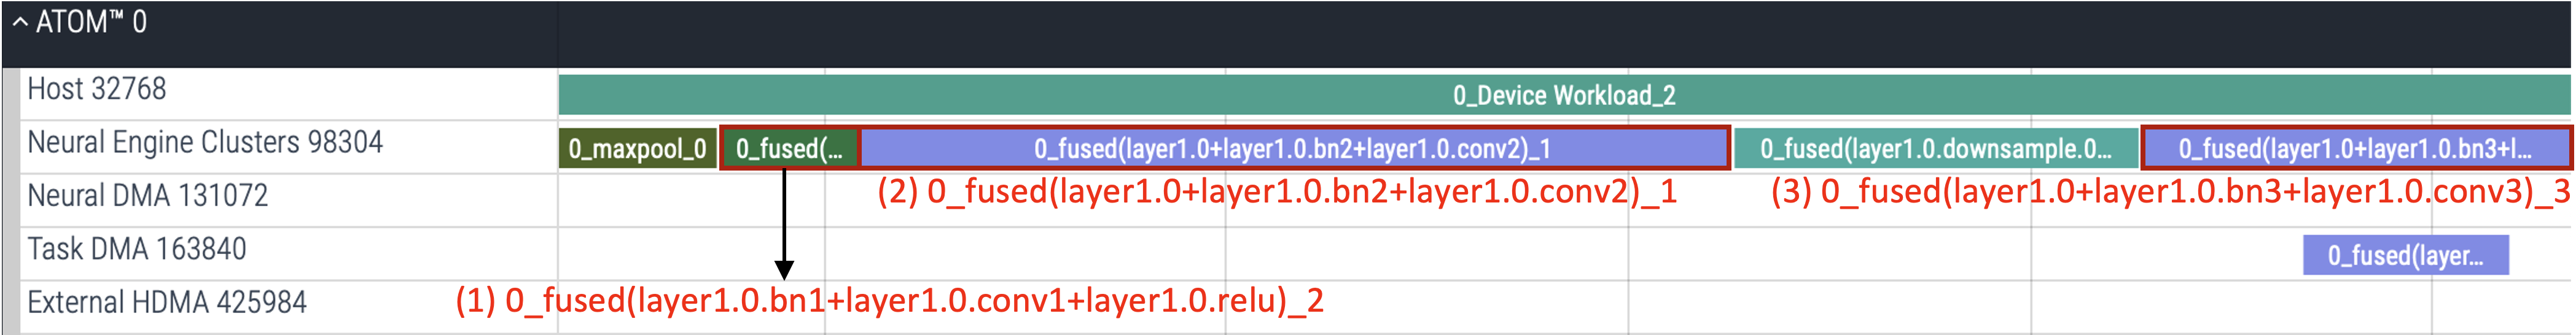
torch.add, torch.nn.functional.relu와 같은 inline 연산들은 모델이 해당 연산들의 이름을 속성(attribute)값으로 갖고 있지 않습니다. 그렇기 때문에 해당 연산들은 컴파일 과정에서 이름이 없어지게 됩니다. 따라서, Perfetto 상에서 어떤 명령어들이 각 연산에 대응하는지 구분하기가 어려울 수 있습니다. 이러한 상황을 방지하기 위해 inline 연산 대신 torch.nn.Module을 상속받는 클래스를 명시적으로 사용할 것을 권장합니다.
또한, 단일 클래스 속성(attribute)을 여러 번 반복해서 사용하는 경우에도 Perfetto 상의 어떤 명령어가 실제로 어떤 연산에 대응하는지 알아보기 어려울 수 있습니다. 파이토치에서 제공하는 ResNet50에서, Bottleneck 모듈은 nn.ReLU 클래스를 사용하기 위해서 self.relu를 명시적으로 한 번만 정의하였습니다. 이 경우, 위의 프로파일링 결과에서 볼 수 있듯 relu라는 이름은 첫 번째를 제외한 두 번째와 세 번째 Neural Engine Clusters 명령어에서 빠져 있습니다. 이는 하나의 self.relu 속성을 forward 함수에서 반복해서 사용했기 때문입니다.
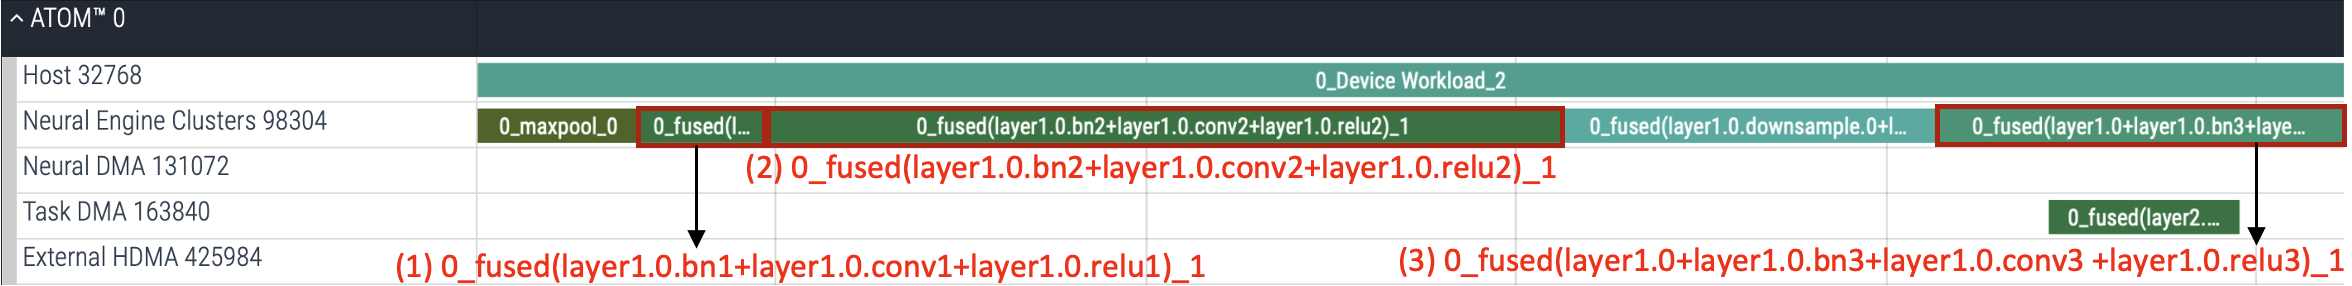
위 파이토치 코드에서 Bottleneck 모듈의 forward 함수를 위와 같이 서로 다른 속성(self.relu1, self.relu2, self.relu3)을 사용하도록 변경하면 첫 번째 Neural Engine Clusters 명령어 이름 (1) 외에 그 이후 명령어 (2), (3)에도 relu가 생략되지 않고 명시적으로 포함됩니다.