gpt-oss-20b
이 사례에서는 RBLN vLLM으로 gpt-oss-20b를 실행하고, RBLN 프로파일러로 Rebel100™에서의 실행 과정을 분석합니다.
프로파일러 활성화에는 Qwen3-1.7B(텍스트 생성) 사례와 동일하게 RBLN_PROFILER=1을 사용합니다. 이 사례에서는 vLLM 엔진이 모델 실행을 관리하므로, 측정 구간은 start_profile()과 stop_profile()로 지정합니다.
이 페이지는 Rebel100™ 디바이스 하나에서 실행하는 가장 단순한 구성을 소개합니다. 트레이스는 워커 프로세스(랭크)마다 하나씩 생성되므로, 랭크 하나로 실행하면 트레이스도 하나입니다. 프레임워크의 실행이 디바이스에 어떻게 대응되는지 확인하기에 가장 좋은 형태입니다.
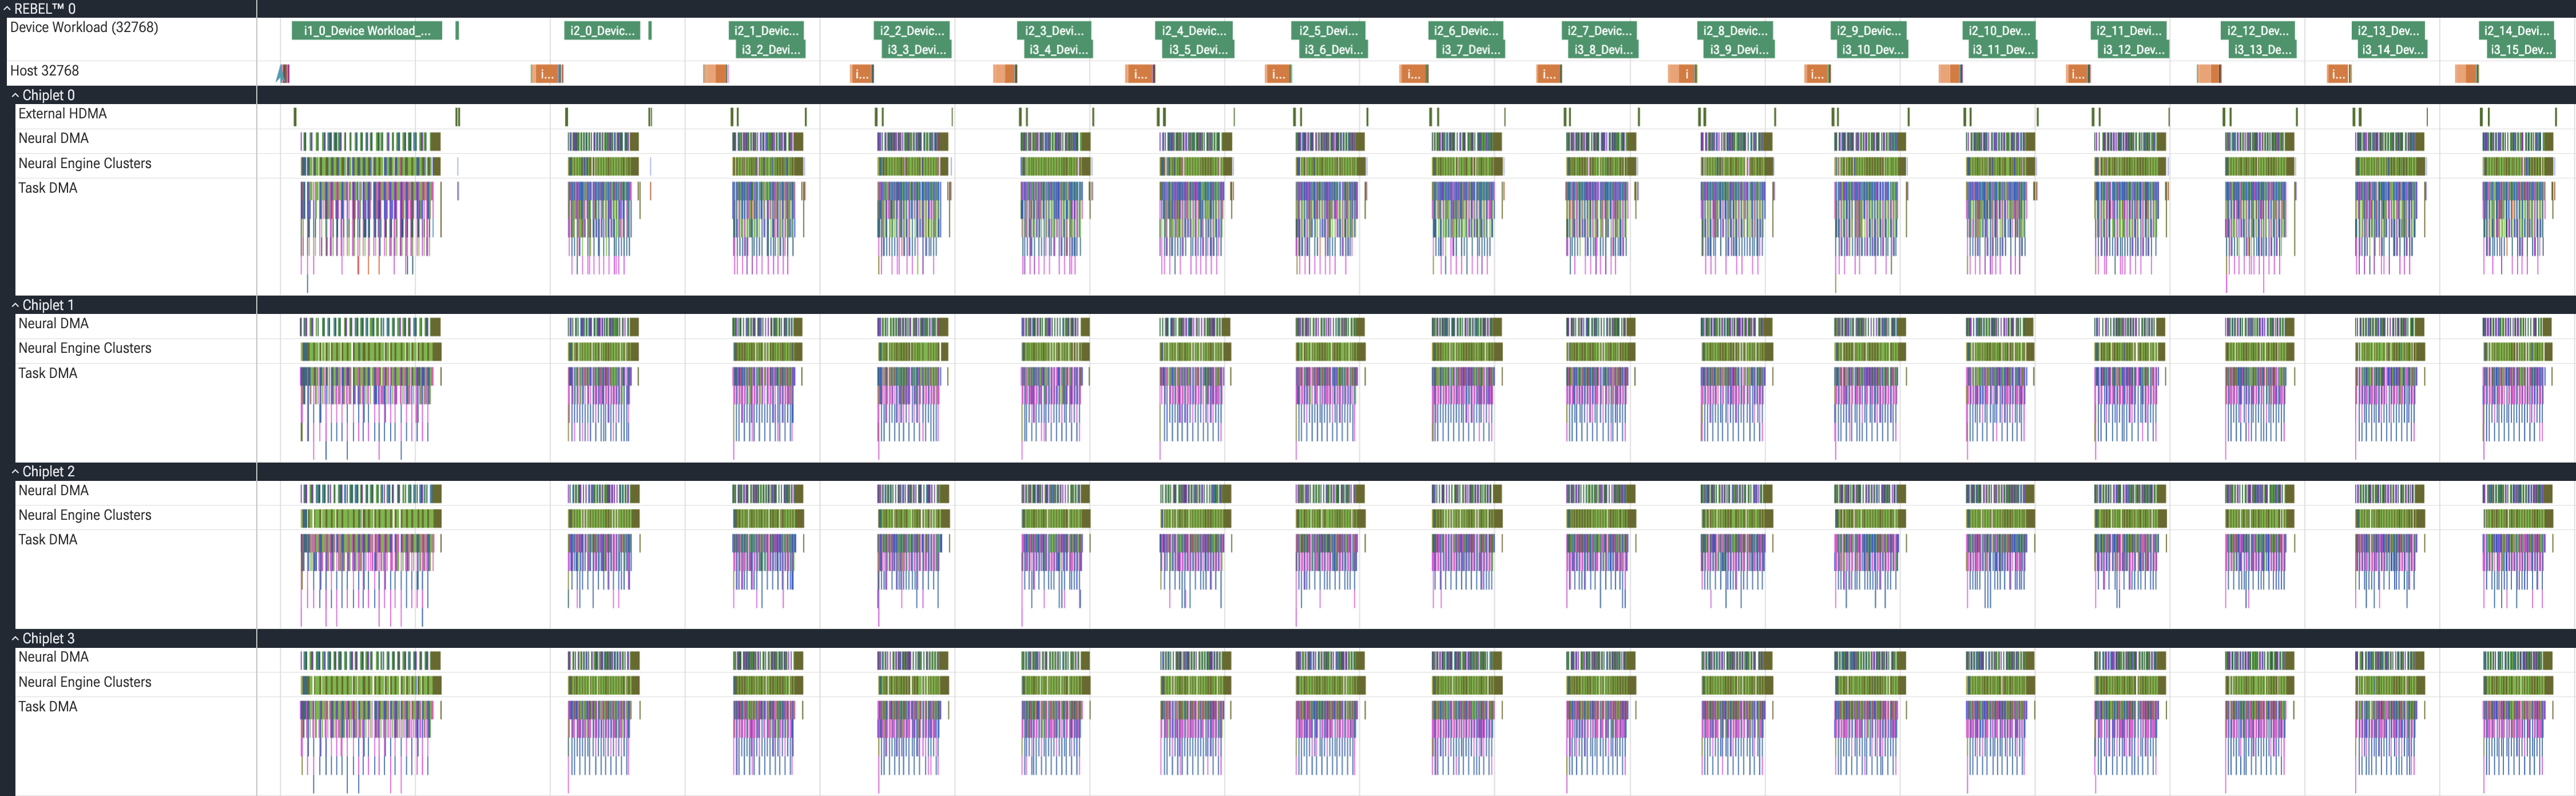
또한 한 번의 모델 실행으로 완료되는 기존 모델 추론과 달리, LLM에서는 추론 요청 하나가 여러 번의 prefill/디코더 및 샘플러 등의 모델 실행으로 이루어집니다. 서빙 프레임워크는 최적의 성능을 위해 서로 다른 컴파일된 모델(디코더, 샘플러 등)을 비동기로 디스패치하기도 합니다. 이 페이지에서는 이처럼 여러 디코드 스텝으로 이루어지고 비동기로 실행되는 구간을 전반적으로 프로파일링하는 사례를 다룹니다.
사전 준비
설치
vllm-rbln 설치는 RBLN vLLM의 설치 방법을 따릅니다. 이 페이지의 예시 스크립트는 vllm-rbln 저장소의 examples/ 아래에 있으므로, 소스 코드 설치로 저장소를 받아 두면 함께 준비됩니다.
추론을 통한 프로파일링 데이터 추출
데이터 병렬 실행 구성은 vllm-rbln의 data_parallel_offline.py를 참고합니다. 프로파일링할 때는 모델에 맞는 실행 설정을 유지하고, LLM 생성 시 profiler_config를 전달합니다. 워밍업 후 start_profile()과 stop_profile()로 추론 구간을 지정합니다.
RBLN 프로파일러는 vllm model implementation에서 동작하며, LLM에 model_impl="vllm"을 지정해 선택합니다.
--dp-size로 데이터 병렬 크기를 지정합니다. 이 페이지에서는 1로 두고, 여러 랭크로 나눈 실행을 프로파일링하는 경우는 gpt-oss-20b(데이터 병렬)에서 다룹니다.
profiler_config 설정에 따라 start_profile()과 stop_profile()이 제어하는 프로파일러가 달라집니다.
- 위 예시처럼
"profiler": "torch"가 지정된 경우: PyTorch 프로파일러가 세션을 열고 닫으며, RBLN 트레이스가 그 트레이스 안으로 병합됩니다. 자세한 내용은 PyTorch 프로파일러 연동에서 확인할 수 있습니다. profiler_config를 빼고 실행한 경우: RBLN 프로파일러를 직접 구동하는 경로가 선택되어,start_profile()과stop_profile()시점에 RBLN 프로파일러 세션이 시작되고 종료됩니다.
stop_profile()은 트레이스 기록이 끝난 뒤에 반환되므로, 프로세스가 종료되기 전에 *.pb 파일이 디스크에 기록됩니다.
실행이 끝나면 두 프로파일러가 각각의 산출물을 남깁니다. RBLN 프로파일러의 트레이스는 랭크별 디렉터리 아래에 .pb 파일로, PyTorch 프로파일러의 chrometrace는 torch_profiler_dir로 지정한 디렉터리에 놓입니다.
이 chrometrace에는 프레임워크 연산뿐 아니라 RBLN 프로파일러가 수집한 디바이스 슬라이스도 함께 담깁니다. 따라서 같은 실행에 대해 디바이스만 담은 .pb와, 프레임워크와 디바이스를 함께 담은 chrometrace가 모두 남습니다. 디바이스 실행만 볼 때에는 .pb를, 프레임워크 호출과 함께 볼 때에는 chrometrace를 엽니다. 후자는 PyTorch 프로파일러 연동에서 다룹니다.
Warning
start_profile()과 stop_profile()로 프로파일링 구간을 지정하지 않으면 트레이스를 잃을 수 있습니다. 워커가 별도 프로세스에서 실행되는 다중 프로세스 구성에서는 엔진이 종료될 때 워커가 정리되는데, 그 전에 트레이스가 기록되지 않으면 결과가 남지 않습니다. stop_profile()은 모든 워커가 기록을 마친 뒤에 반환되므로, vLLM의 프로파일링 사용법대로 프로파일링 구간을 start_profile()과 stop_profile()로 감싸야 합니다.
Tip
LLM에 profiler_config를 전달하면 PyTorch 프로파일러를 함께 켜서 프레임워크 연산까지 볼 수 있습니다. RBLN 프로파일러가 수집한 디바이스 슬라이스가 PyTorch 프로파일러의 chrometrace로 합쳐져, 프레임워크 연산과 디바이스 실행을 한 화면에서 볼 수 있습니다.
이 병합은 Rebel100™에서만 지원되며 ATOM™에서는 사용할 수 없습니다. 설정과 동작은 프로파일링 가이드에서 설명합니다.
RBLN 프로파일러 기반 gpt-oss-20b의 프로파일링 데이터 분석
디코더와 샘플러의 비동기 디스패치
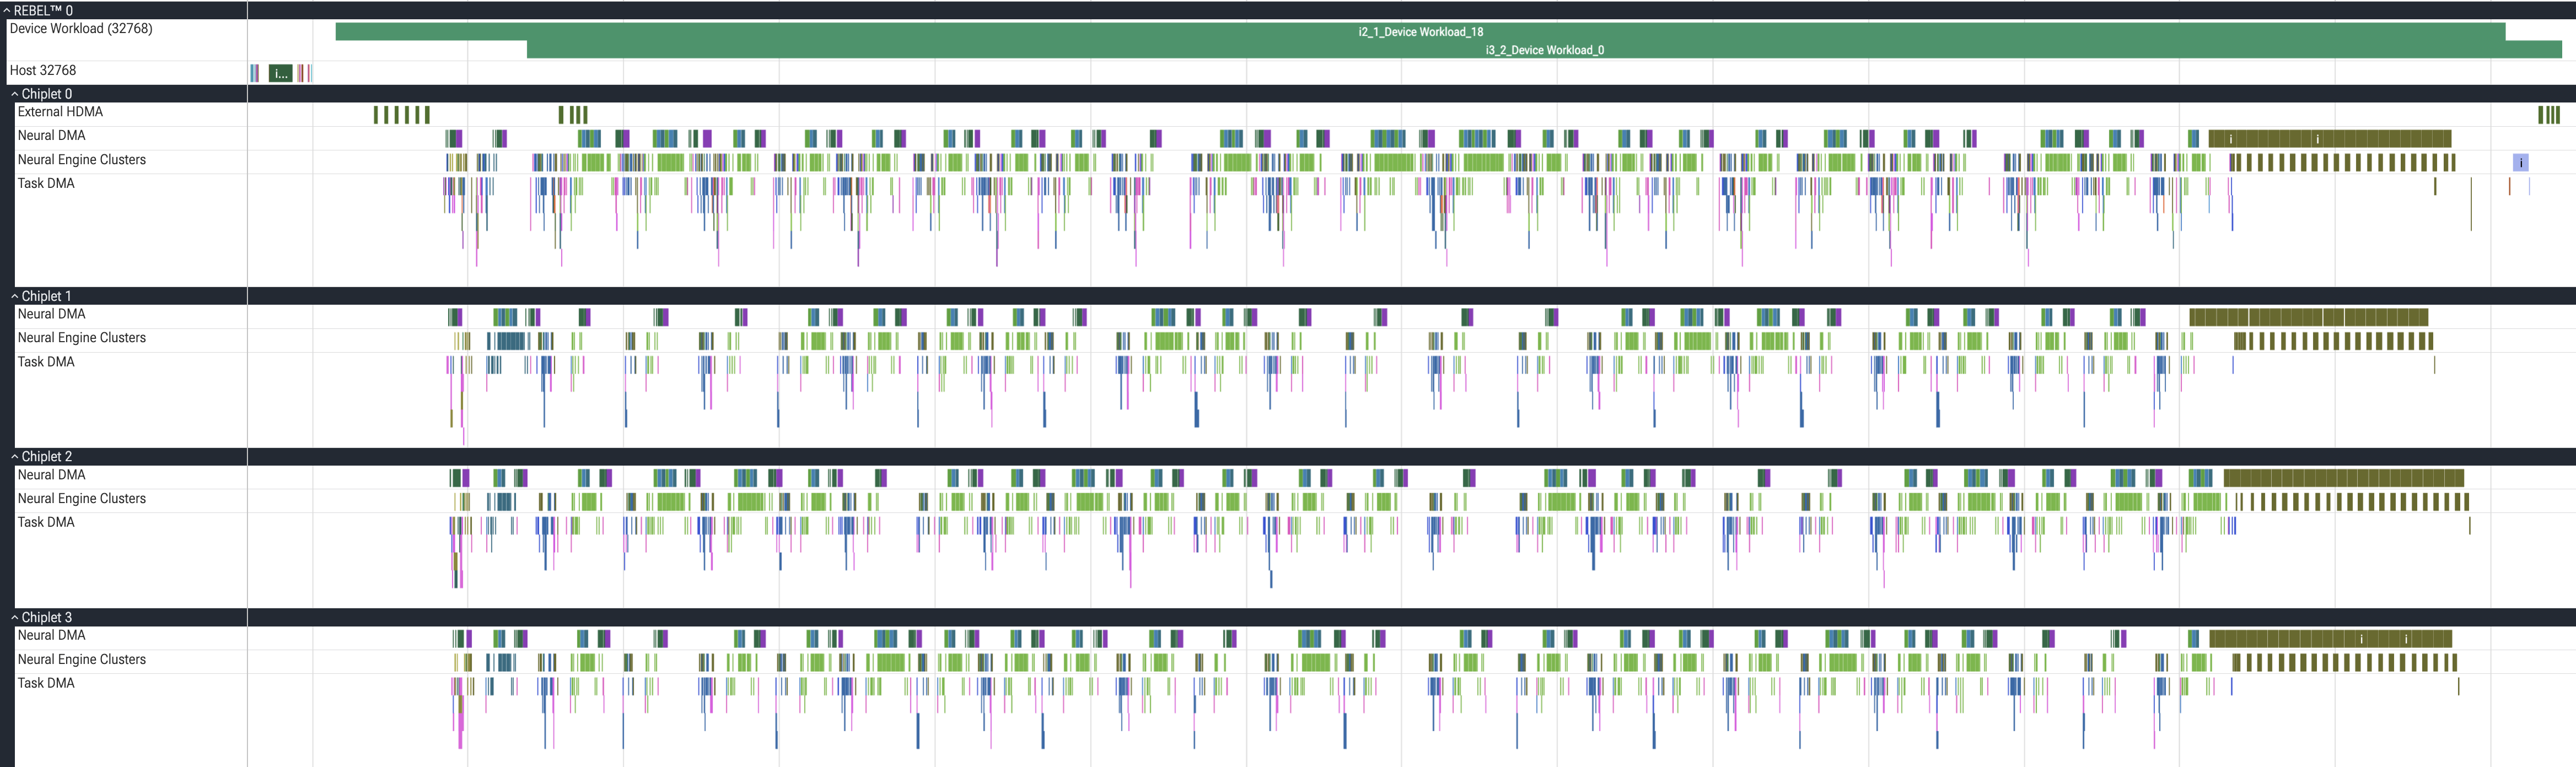
디코드 스텝 한 번은 디코더와 샘플러처럼 서로 다른 컴파일된 모델의 실행으로 나뉘고, 각 실행이 Device Workload 트랙에 자신의 슬라이스를 남깁니다. 어느 슬라이스가 어느 모델의 실행인지는 슬라이스와 명령어에 붙은 이름으로 구별할 수 있습니다. 이름 규칙은 분석 방법에서 설명합니다.
같은 실행에 속한 명령어는 이름에 같은 W{workload_index} 토큰이 붙습니다. 슬라이스의 workload_index로 토큰을 확인한 뒤 트레이스에서 그 토큰을 검색하면, 그 실행이 4개 칩렛에서 각각 어떤 명령어로 수행되었는지 모아 볼 수 있습니다.
프레임워크가 이 실행들을 비동기로 디스패치하므로 각 실행의 슬라이스가 반드시 순차적으로만 놓이지는 않습니다. 비동기로 실행되거나 동시에 진행되는 작업은 슬라이스가 시간상 겹치고, Perfetto는 겹치는 슬라이스를 하나의 트랙 안에 세로로 쌓아 표시하므로 Device Workload 트랙이 여러 층으로 확장됩니다.
스크린샷의 Device Workload 트랙에 쌓인 두 슬라이스가 그 예입니다. 위쪽 i2_1_Device Workload_18이 디코더의 실행이고, 아래쪽 i3_2_Device Workload_0이 샘플러의 실행입니다. 샘플러의 슬라이스는 디코더가 아직 실행 중일 때 시작합니다.
두 실행은 연달아 디스패치됩니다. 샘플러 슬라이스의 앞부분에서는 입력을 받는 External HDMA가 먼저 수행되고, Neural Engine Clusters의 연산은 디코더의 명령어가 모두 끝난 뒤에 시작하는 것을 확인할 수 있습니다.
PyTorch 프로파일러 연동
Info
이 연동에는 torch-rbln이 필요합니다. 설치되어 있지 않으면 PyTorch 프로파일러 산출물인 chrometrace에 PyTorch 프레임워크 연산만 담깁니다.
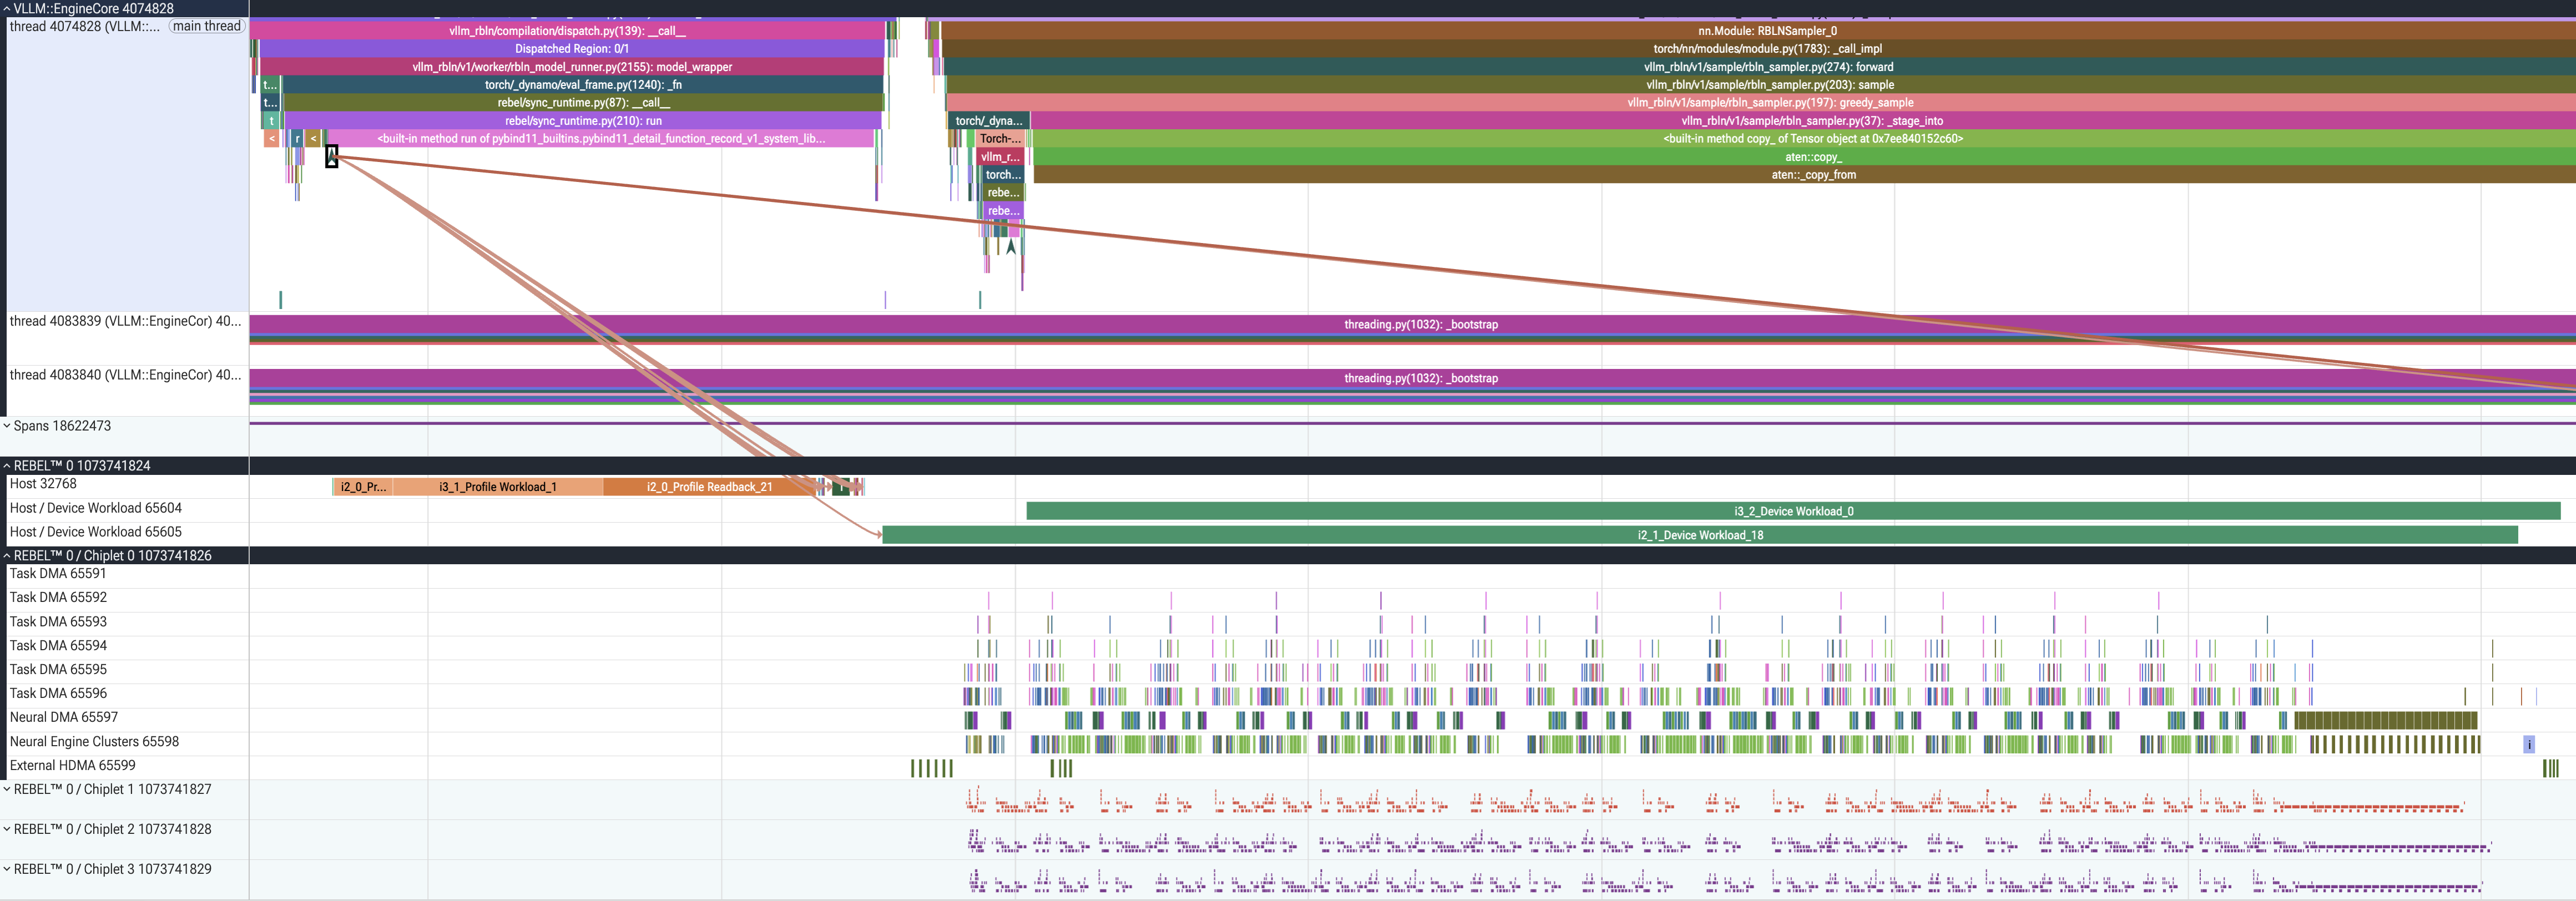
PyTorch 프로파일러를 함께 켜면 프레임워크 연산과 디바이스 실행이 하나의 chrometrace에 담깁니다. 다만 런타임이 디바이스 작업을 비동기로 디스패치하는 경우에는, 디바이스 작업이 그것을 실행시킨 함수의 실행 구간 안에 반드시 들어오지는 않습니다. 시간만 보고는 어느 연산이 어느 디바이스 작업을 일으켰는지 판단하기 어려운 경우가 생깁니다.
이때 두 계층을 이어 주는 것이 launch_id입니다. 런타임 호출이 시작되는 호스트 지점에는 rbln_run 슬라이스가 표시되고, 그 호출이 만들어 낸 디바이스 슬라이스에는 모두 같은 launch_id가 붙습니다. Perfetto는 이 대응을 흐름 화살표로 그리므로, 디바이스 슬라이스를 선택하면 시간상 겹치지 않더라도 그것을 실행시킨 호스트 호출로 거슬러 올라갈 수 있고 반대 방향으로도 따라갈 수 있습니다.