AI 엔지니어를 위한 RBLN SDK
개요
RBLN SDK는 Rebel100™에서 딥러닝 모델을 컴파일하고 실행·서빙하는 소프트웨어 도구를 제공하며, RBLN vLLM을 사용한 컴파일·서빙을 권장합니다. RBLN vLLM의 model_impl을 vllm으로 두느냐 transformers(RBLN Optimum)로 두느냐에 따라, 아래 그림처럼 참조하는 RBLN SDK 구성 요소가 달라집니다. 어느 경로를 선택하든 최종 컴파일은 RBLN Compiler가 담당합니다.
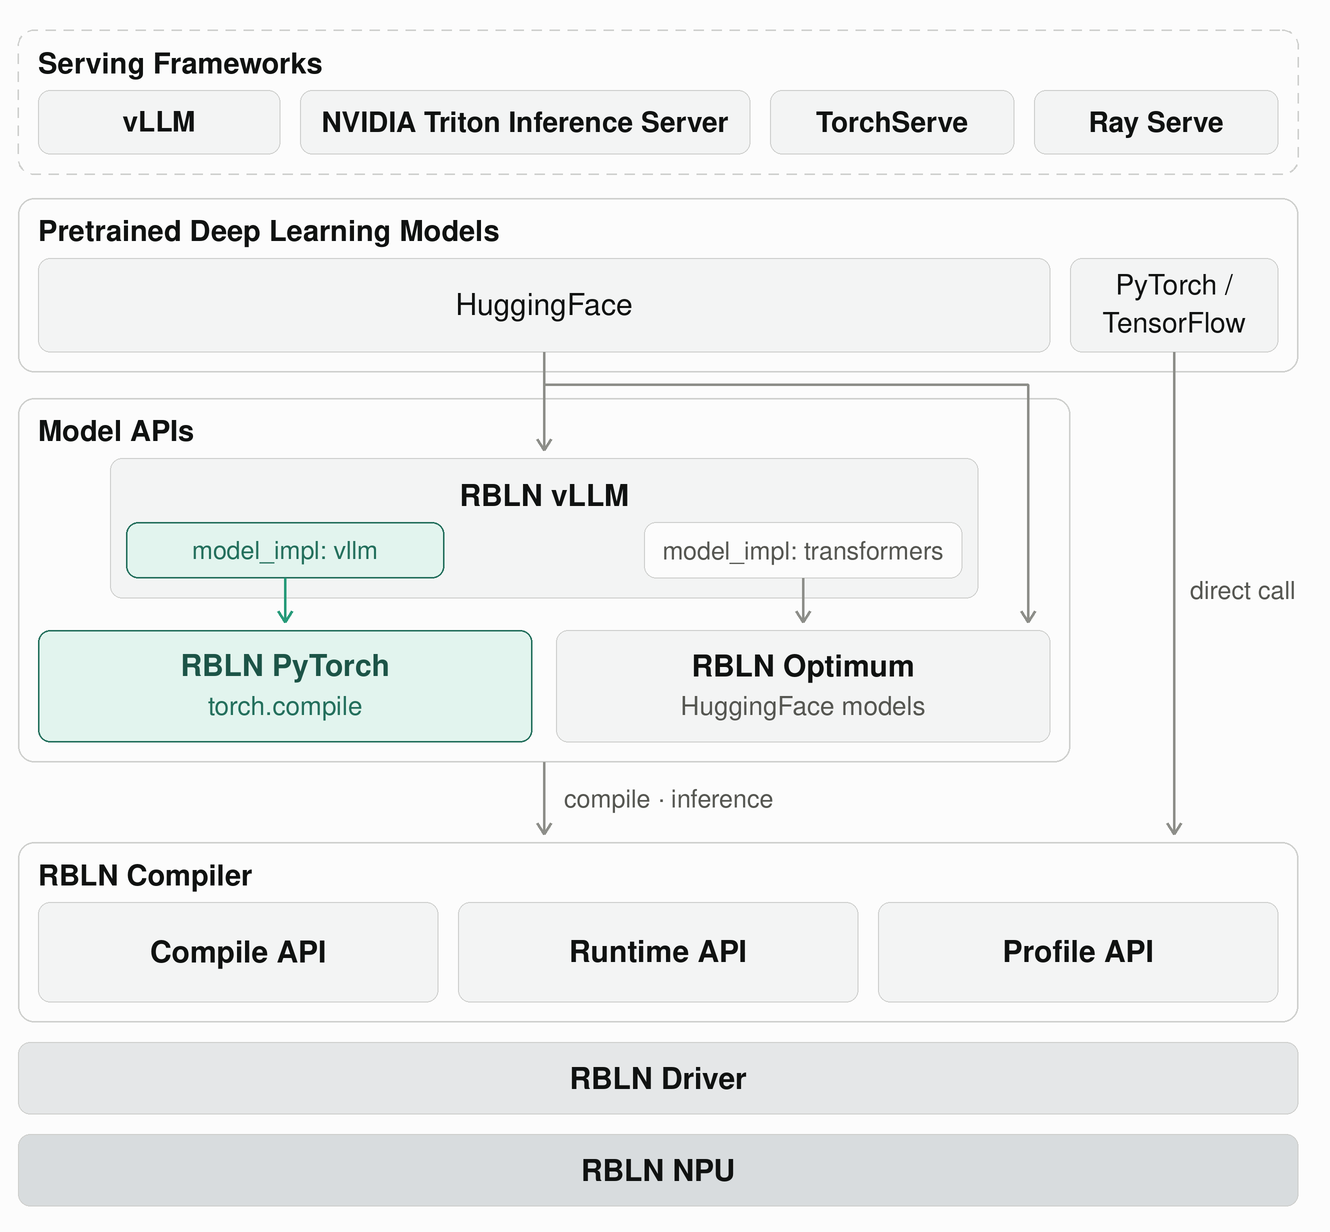
RBLN vLLM은 vllm serve로 OpenAI 호환 추론 서버를 실행합니다. model_impl이 vllm이면 모델 코드를 vLLM 자체 모델 정의에서, transformers이면 optimum-rbln에서 가져옵니다. vllm 구현에서는 엔진 시작 시 torch.compile로 모델을 컴파일하며, RBLN PyTorch가 이 경로에서 PyTorch 텐서를 RBLN NPU에 배치할 수 있도록 지원합니다. 검증된 설치·서빙 예시는 Rebel100™ 모델별 Recipes에서 확인할 수 있습니다.
RBLN Optimum은 지원하는 HuggingFace transformers·diffusers 모델을 애플리케이션에서 사용할 수 있도록 클래스와 파이프라인을 제공합니다. 이 중 RBLN vLLM의 transformers 구현이 지원하는 모델은 추론 서버로도 실행할 수 있습니다.
RBLN Compiler는 모델 API에서 사용하는 컴파일·런타임 기능을 제공합니다. 그림의 "direct call"은 RBLN vLLM이나 RBLN Optimum을 거치지 않고 이 API를 직접 사용하는 경로입니다. Compile API로 PyTorch·TensorFlow 모델을 컴파일한 뒤, Python 또는 C/C++에서 Runtime API를 호출해 컴파일된 모델로 추론합니다.
RBLN Profiler로 실행 시간과 메모리 사용량을 분석하여 성능 병목을 찾을 수 있습니다.
미리 컴파일된 RBLN 모델은 NVIDIA Triton Inference Server, TorchServe, Ray Serve로도 서빙할 수 있습니다.
- RBLN SDK를 처음 사용한다면 빠른 시작으로 모델을 실행할 수 있습니다.
- 모델이 정해져 있다면 모델별 Recipes를 통해 빠르게 서빙할 수 있습니다.
- NPU 할당 및 인프라 운영은 시스템 관리자 가이드에서 다룹니다.
RBLN SDK는 ATOM™에서 딥러닝 모델을 컴파일하고 실행·서빙하는 소프트웨어 도구를 제공합니다. RBLN vLLM은 RBLN Optimum의 API를 이용하여 모델을 컴파일하고 서빙하며 최종 컴파일은 RBLN Compiler가 담당합니다.
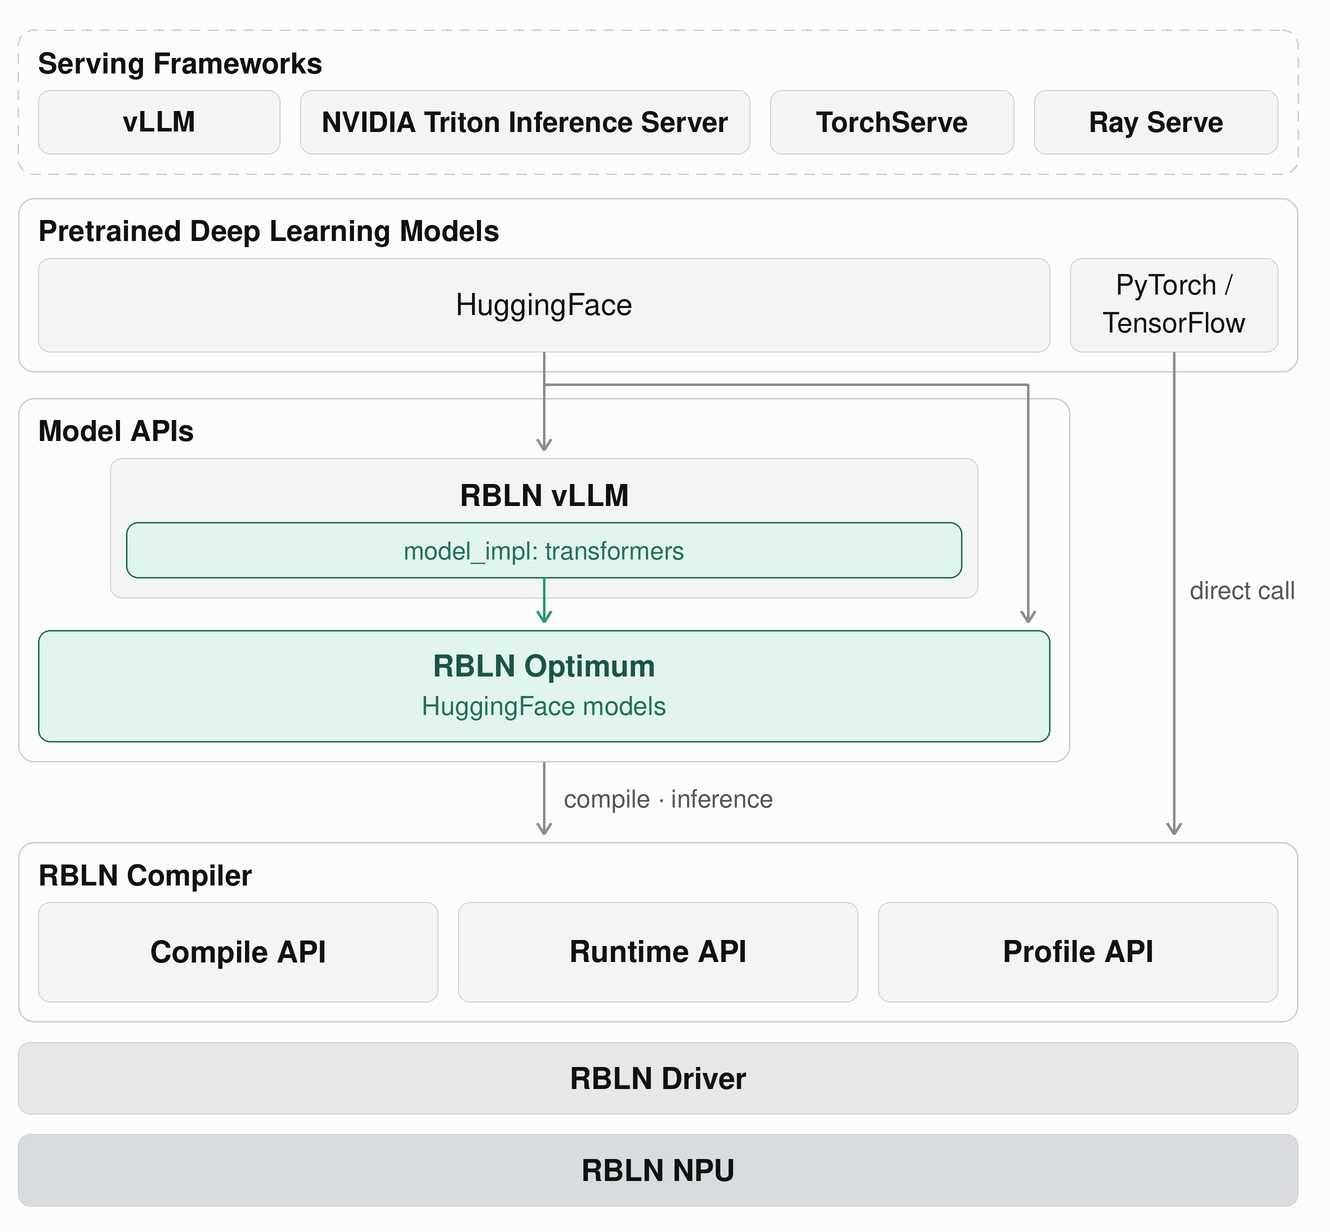
RBLN vLLM은 vllm serve로 OpenAI 호환 추론 서버를 실행합니다. 모델은 두 가지 방식으로 서빙할 수 있습니다. vllm serve에 HuggingFace 모델 ID를 직접 전달하면 RBLN vLLM이 내부적으로 RBLN Optimum API를 호출하여 모델을 컴파일합니다. 또는 사용자가 RBLN Optimum API로 모델을 미리 컴파일하고 저장한 뒤, 해당 디렉터리를 vllm serve에 전달하여 불러올 수 있습니다. 검증된 설치·서빙 예시는 ATOM™ 모델별 Recipes에서 확인할 수 있습니다.
RBLN Optimum은 지원하는 HuggingFace transformers·diffusers 모델의 클래스와 파이프라인을 제공합니다. 애플리케이션에서 모델을 사용할 수 있도록 컴파일과 추론을 처리합니다. 컴파일된 모델을 저장한 뒤 배포 환경에서 다시 불러올 수도 있습니다.
RBLN Optimum은 RBLN Compiler를 통해 ATOM™에서 컴파일과 추론을 수행합니다. 그림의 "direct call"은 RBLN vLLM이나 RBLN Optimum을 거치지 않고 이 API를 직접 사용하는 경로입니다. Compile API로 PyTorch·TensorFlow 모델을 컴파일한 뒤, Python 또는 C/C++에서 Runtime API를 호출해 컴파일된 모델로 추론합니다.
RBLN Profiler로 실행 시간과 메모리 사용량을 분석하여 성능 병목을 찾을 수 있습니다.
미리 컴파일된 RBLN 모델은 NVIDIA Triton Inference Server, TorchServe, Ray Serve로도 서빙할 수 있습니다.
- RBLN SDK를 처음 사용한다면 빠른 시작으로 모델을 실행할 수 있습니다.
- 모델이 정해져 있다면 모델별 Recipes를 통해 빠르게 서빙할 수 있습니다.
- NPU 할당 및 인프라 운영은 시스템 관리자 가이드에서 다룹니다.
시작하기
RBLN SDK 사용자 가이드의 주요 페이지는 다음과 같습니다. 질문이나 피드백이 있으면 문의해 주시기 바랍니다.
-
 RBLN Compiler
-
 RBLN C/C++ Runtime API
- 설치
- C/C++ Runtime API
- 튜토리얼
-
 RBLN Optimum(HuggingFace 모델 지원)
- 개요
- 설치
- 튜토리얼
- 문제 해결
- Model API
- Main Class
- Auto Classes
- Transformers
- Diffusers
- Main Class
-
 모델 서빙(vLLM)
-
 모델 서빙(NVIDIA Triton Inference Server)
-
 모델 서빙(TorchServe)
-
 모델 서빙(Ray Serve)
-
 RBLN Profiler 소개
- RBLN Profiler 튜토리얼
- 기본
- 예제
- ATOM™
- Rebel100™
- RBLN PyTorch
-
 기타
- 지원 모델
- 지원하는 연산
- 에러 코드
-
 지원